DOM의 원리: HTML을 객체로 바꾸고 화면을 수정하기
DOM은 HTML 문서를 JavaScript가 읽고 수정할 수 있도록 표현한 객체 트리다. HTML과 DOM의 차이, 노드 조회와 조작, 스크립트 실행 시점을 알아보고 SPA와 React로 이어지는 흐름을 살펴본다.
왜 DOM이 필요한가
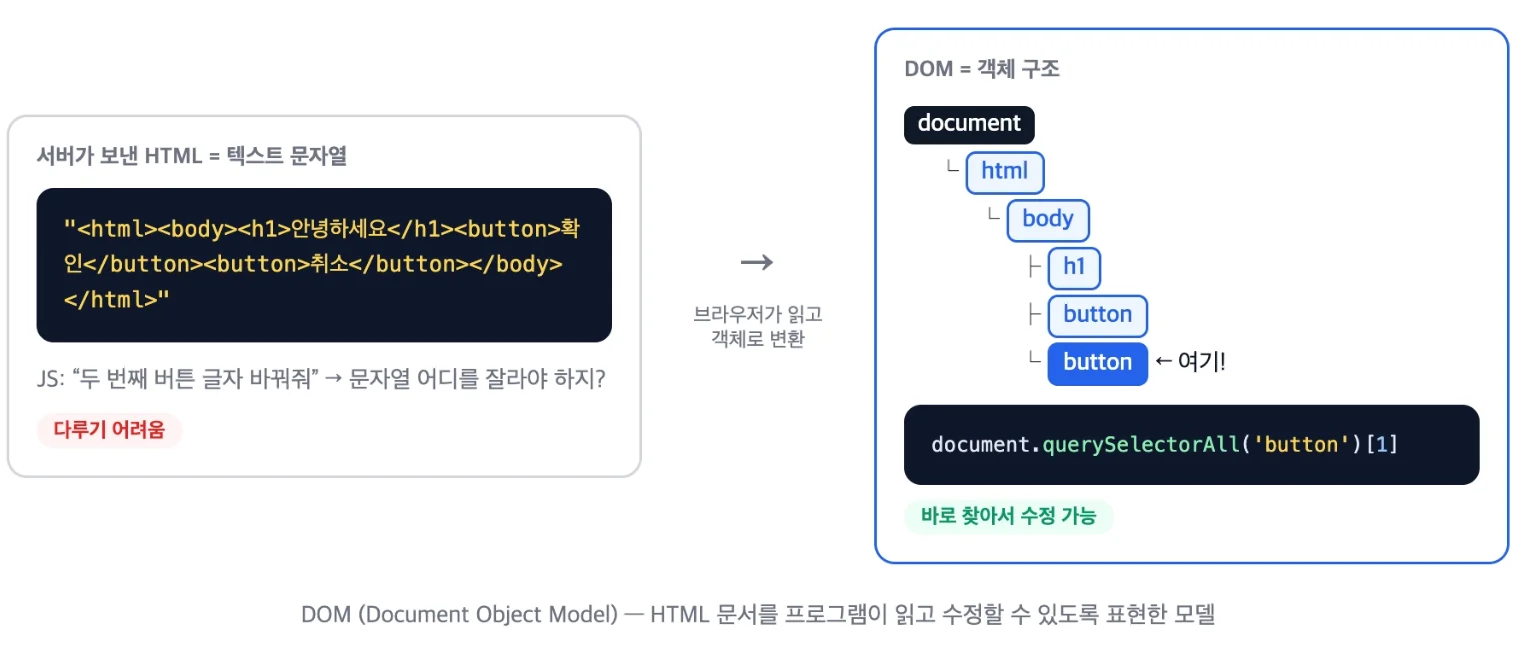
- 웹페이지는 HTML, CSS, JavaScript로 만들어진다.
- 이 중 HTML은 서버가 브라우저에 보내주는 텍스트 문자열이다.
- 문자열 상태에서는 "두 번째 버튼의 글자를 바꿔라" 같은 작업을 JavaScript가 처리하기 어렵다.
- 그래서 브라우저는 HTML을 읽은 뒤, JavaScript가 다룰 수 있는 객체 구조로 변환한다.
- 이렇게 만들어진 객체 구조를 DOM(Document Object Model)이라고 부른다.
- 정리하면 DOM은 HTML 문서를 프로그램이 읽고 수정할 수 있도록 표현한 모델이다.
DOM은 트리 구조이다
-
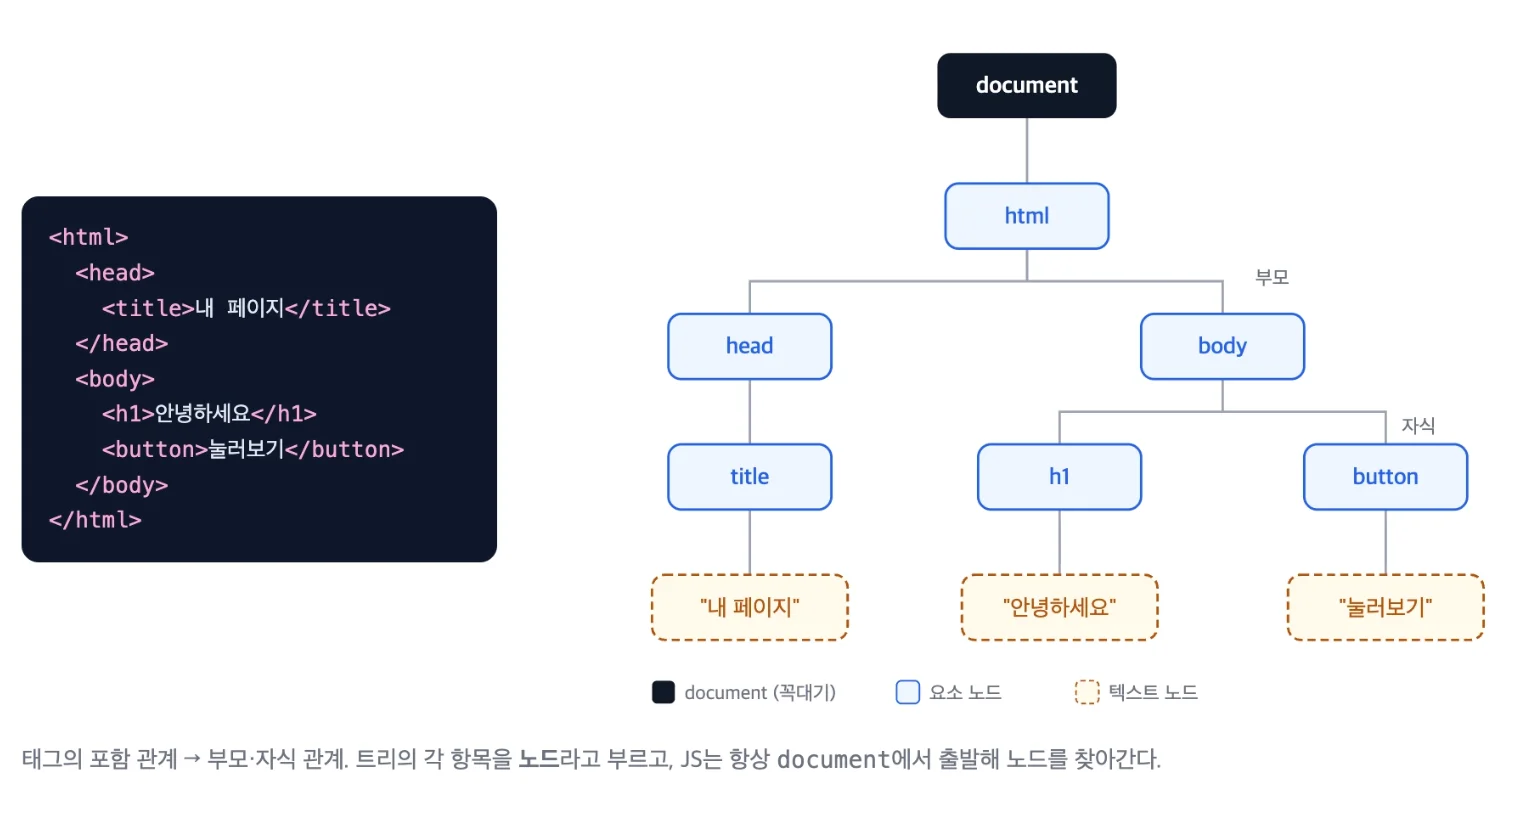
HTML 태그는 다른 태그를 안에 담을 수 있다.
<html> <head> <title>내 페이지</title> </head> <body> <h1>안녕하세요</h1> <button>눌러보기</button> </body> </html> -
이 포함 관계를 그대로 옮기면 부모와 자식으로 이어지는 트리가 된다.
document html head title "내 페이지" body h1 "안녕하세요" button "눌러보기" -
트리를 이루는 각 항목을 노드(node)라고 부른다.
-
노드에는
h1같은 태그를 나타내는 요소 노드와, 그 안의 글자를 나타내는 텍스트 노드 등이 있다. -
위의 트리는 이해를 돕기 위해 줄인 것이고, 실제 DOM에는 태그 사이의 줄바꿈과 들여쓰기도 텍스트 노드로 들어 있다.
-
그래서 모든 자식 노드를 담는
childNodes와 요소만 담는children은 개수가 서로 다르다.// 위 HTML 기준 document.body.childNodes.length; // 5: 공백, h1, 공백, button, 공백 document.body.children.length; // 2: h1, button -
화면에서 이 공백이 보이지 않는 것은 DOM에서 지워졌기 때문이 아니라, CSS가 화면을 그릴 때 대부분 무시하기 때문이다.
-
이 모든 노드의 꼭대기에는
document객체가 있다. -
JavaScript는
document에서 출발해 원하는 노드를 찾아간다.
HTML과 DOM은 같은 것이 아니다
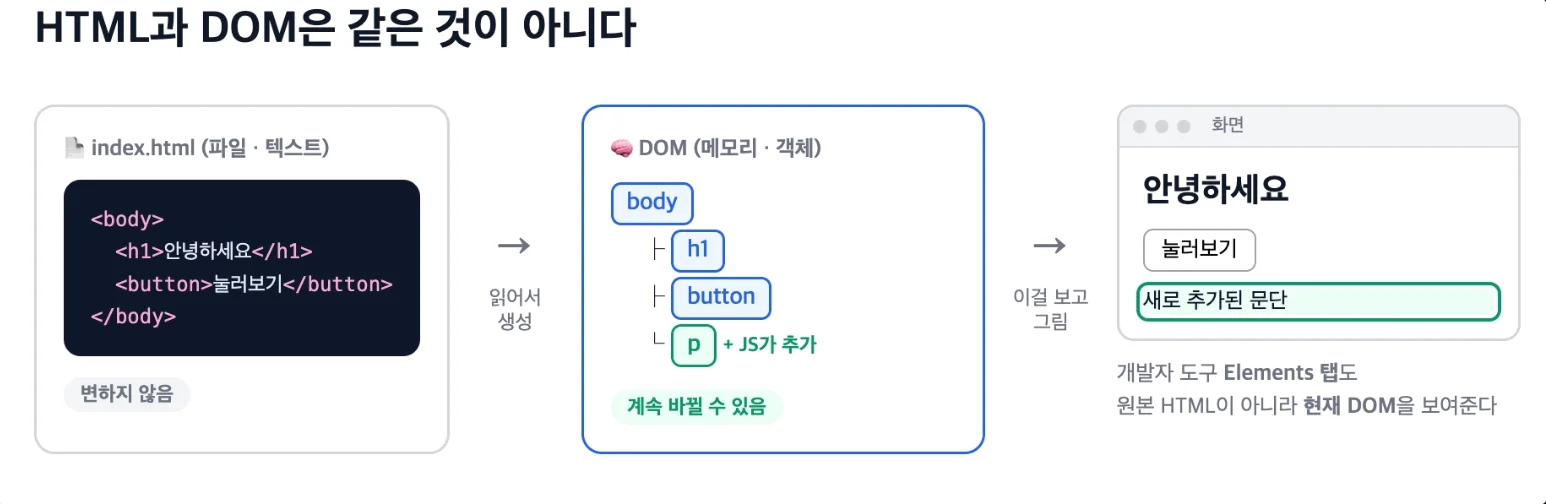
- HTML은 파일에 적힌 텍스트이다.
- 반면 DOM은 브라우저가 그 텍스트를 읽고 메모리에 만든 객체이다.
- 둘이 별개이기 때문에, DOM은 만들어진 뒤에 HTML 파일과 다른 모습으로 바뀔 수 있다.
- 예를 들어 JavaScript가 DOM에 노드를 추가해도 원본 HTML 파일은 그대로이다.
- 이때 브라우저가 화면을 그리는 기준은 HTML 파일이 아니라 현재의 DOM이다.
- 개발자 도구의 Elements 탭에서 보이는 내용도 원본 HTML이 아니라 현재의 DOM이다.
- JS가 손대지 않아도 둘이 달라지는 경우가 있는데, 브라우저가 HTML을 읽는 단계에서 생략된 부분을 채워 넣기 때문이다.
- 예를 들어 파일에
<p>안녕</p>한 줄만 적혀 있어도, 만들어진 DOM에는html,head,body요소가 모두 존재한다. - 반대로 DOM에는 있지만 화면에 보이지 않는 경우도 있는데, CSS로
display: none이 적용된 요소가 그렇다. - 따라서 HTML 파일, DOM, 화면에 보이는 것은 서로 이어져 있지만 같지는 않은 세 가지로 구분해 두는 편이 좋다.
- 이 구분은 React 프로젝트에서 더 뚜렷해지는데,
index.html에는 빈<div>하나만 있어도 Elements 탭에는 화면 전체의 요소가 보이기 때문이다.
JavaScript로 DOM 바꾸기
-
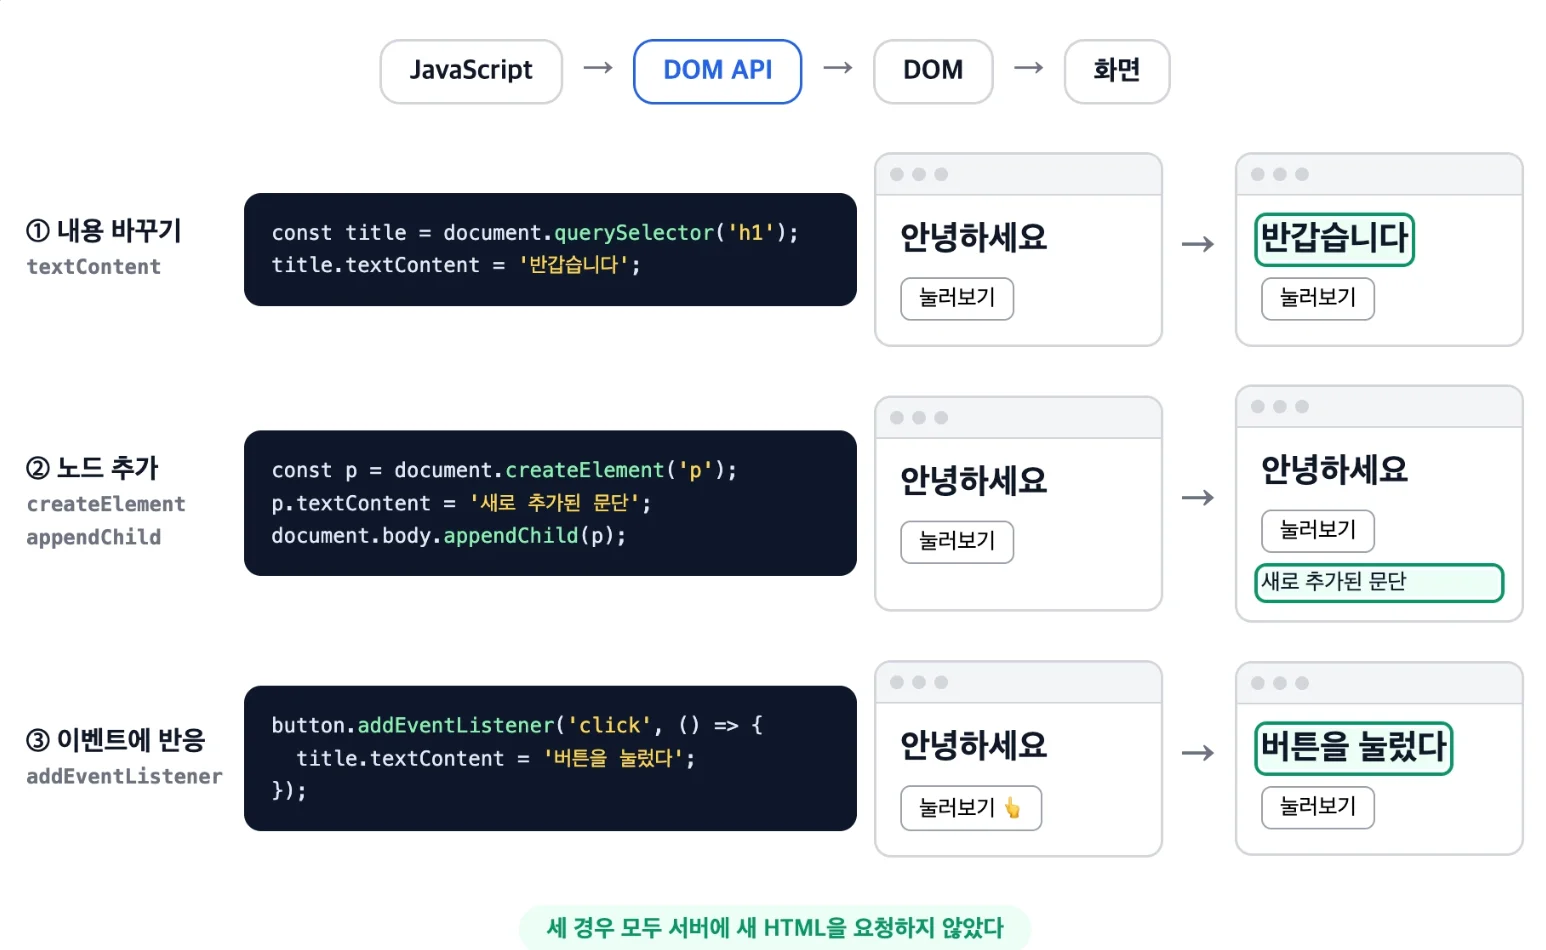
브라우저는 DOM을 기준으로 화면을 그리므로, DOM을 바꾸면 화면도 함께 바뀐다.
-
이를 위해 브라우저는 DOM을 다루는 함수 모음인 DOM API를 JavaScript에 제공한다.
-
DOM API는 JavaScript 언어 자체에 포함된 기능이 아니라, 브라우저라는 실행 환경이 추가로 제공하는 기능이다.
-
그래서 브라우저가 아닌 Node.js에서 같은 코드를 실행하면
document가 정의되어 있지 않다는 오류가 난다. -
먼저
querySelector로 바꾸려는 노드를 찾고, 그 노드의textContent를 바꾸면 화면의 글자가 바뀐다.const title = document.querySelector('h1'); title.textContent = '반갑습니다'; -
내용을 바꾸는 것뿐 아니라,
createElement로 새 노드를 만들어appendChild로 트리에 붙일 수도 있다.const p = document.createElement('p'); p.textContent = '새로 추가된 문단'; document.body.appendChild(p); -
여기에
addEventListener를 더하면 클릭 같은 사용자 행동이 일어났을 때 DOM을 바꿀 수 있다.const button = document.querySelector('button'); button.addEventListener('click', () => { title.textContent = '버튼을 눌렀다'; }); -
세 경우 모두 서버에 새 HTML을 요청하지 않고 화면이 바뀌었다는 점을 눈여겨볼 만하다.
실행 시점: 요소가 만들어진 뒤에 찾아야 한다
-
앞의 코드는 찾으려는 요소가 이미 DOM에 만들어져 있을 때만 동작한다.
-
querySelector는 조건에 맞는 요소가 없으면null을 돌려주므로, 이어지는title.textContent에 접근하는 순간 오류가 난다. -
브라우저는 HTML을 위에서부터 읽다가 일반
<script>를 만나면 읽기를 멈추고 스크립트를 먼저 실행하는데, 이때 그 아래쪽 태그는 아직 DOM에 없다. -
그래서
<script>를<head>에 두면<body>안의 요소를 찾지 못하는 일이 생긴다.<head> <script> document.querySelector('h1'); // null: h1은 아직 만들어지지 않았다 </script> </head> <body> <h1>안녕하세요</h1> </body> -
이를 피하기 위해
<script>를<body>의 끝에 두거나,<script type="module">을 사용한다. -
type="module"스크립트는 HTML을 끝까지 읽은 뒤에 실행되는 것이 기본 동작이기 때문이다. -
뒤에서 볼 React 프로젝트의
index.html도type="module"을 사용한다.
DOM에서 SPA로 이어지는 흐름
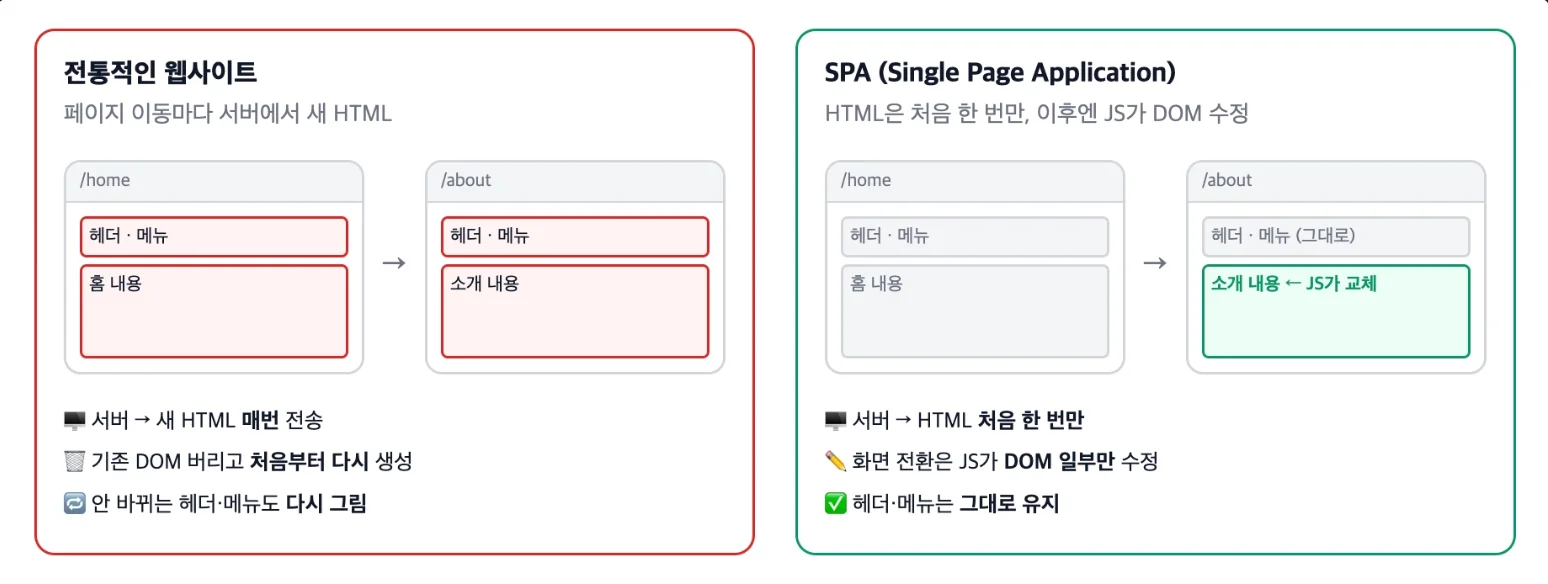
- 전통적인 웹사이트에서는 다른 페이지로 이동할 때마다 서버에서 새 HTML을 받아온다.
- 새 HTML을 받으면 브라우저는 기존 DOM을 버리고 처음부터 다시 만든다.
- 그 결과 헤더나 메뉴처럼 바뀌지 않는 부분도 매번 다시 그려진다.
- 그런데 앞에서 본 것처럼 JavaScript는 서버에서 새 HTML을 받지 않고도 DOM을 바꿀 수 있다.
- 그렇다면 HTML은 처음 한 번만 받고, 이후의 화면 전환은 JavaScript가 DOM을 바꿔서 처리하는 방식도 가능하다.
- 이 방식으로 만든 웹 애플리케이션을 SPA(Single Page Application)라고 부른다.
직접 조작의 한계와 React
- SPA에서는 모든 화면 변화를 DOM 조작으로 처리하므로, 화면이 복잡해질수록 어떤 노드를 언제 바꿔야 하는지 직접 관리하기가 어려워진다.
- React는 이 DOM 조작을 대신 관리해주는 도구로 이해할 수 있다.
- React를 쓰면 "어떤 노드를 어떻게 바꿀지" 대신 "지금 데이터로는 화면이 이런 모습이어야 한다"를 작성한다.
- 그러면 React가 직전 결과와 새 결과를 비교해서, 달라진 부분에 대해서만
createElement,appendChild같은 DOM API를 대신 호출한다. - 즉 React를 써도 DOM API가 사라지는 것은 아니며, 호출하는 주체가 개발자에서 React로 바뀌는 것이다.