Node.js 싱글 스레드의 뜻과 이벤트 루프가 요청을 처리하는 원리
Node.js의 싱글 스레드는 JavaScript 코드와 콜백을 실행하는 메인 스레드가 하나라는 뜻이고, 기다리는 일은 운영체제(epoll)와 libuv thread pool에 맡기기 때문에 스레드 하나로도 많은 요청을 처리한다.
"싱글 스레드"에서 스레드는 무엇인가
- Node.js를 소개하는 글에는 "싱글 스레드"라는 말이 자주 나온다.
- 그런데 Node.js로 만든 서버는 여러 사용자의 요청을 동시에 처리한다.
- 이 두 사실이 어떻게 함께 성립하는지 설명하려면, 싱글 스레드라는 것이 정확히 무엇을 의미하는지 알아야 한다.
- 여기서 스레드는 Node.js가 따로 만든 용어가 아니라, 운영체제가 프로그램을 실행할 때 쓰는 단위를 가리키는 말이다.
- Node.js에서 말하는 스레드도 운영체제의 스레드와 같은 것이고, 달라지는 것은 그 가운데 어느 스레드를 두고 하나라고 말하는가이다.
- 그래서 먼저 운영체제에서 프로세스와 스레드가 무엇인지부터 짚는다.
- 프로그램은 디스크에 저장된 코드이고, 프로그램을 실행하면 운영체제가 프로세스를 만든다.
- 프로세스는 실행 중인 프로그램 하나를 가리키며, 다른 프로세스와 구분되는 자기 메모리를 가진다.
- 스레드는 프로세스 안에서 코드를 한 줄씩 차례로 실행해 나가는 실행 흐름이다.
- 스레드 하나는 한 시점에 한 가지 일만 하므로, 지금 실행 중인 줄이 끝나야 다음 줄로 넘어간다.
- 프로세스에는 스레드가 적어도 하나 있고, 필요하면 여러 개를 둘 수 있다.
- Linux 매뉴얼에 따르면, 한 프로세스의 스레드들은 같은 프로그램을 실행하면서 메모리를 함께 쓰고, 스택은 스레드마다 따로 가진다.
- 스택은 스레드가 지금 어느 함수의 어디까지 실행했는지와 그 함수의 지역 변수를 적어 두는 공간이다.
- 스레드가 여러 개이면 실행 흐름도 여러 개이므로, 한 스레드가 멈춰 있어도 다른 스레드는 자기 코드를 계속 실행한다.
- 운영체제는 이 스레드들을 CPU 코어에 번갈아 배정해서 실행시킨다.
- 따라서 "싱글 스레드"는 이런 실행 흐름이 하나라는 뜻이고, 지금부터 그것이 무엇을 실행하는 흐름인지를 살펴보자.
JavaScript에서 "싱글 스레드"라는 말이 쓰이는 방식
-
JavaScript에서 "싱글 스레드"는 JavaScript 코드를 실행하는 스레드가 하나라는 뜻이다.
-
작성한 코드가 실행 도중에 스레드를 새로 만들어 두 곳을 동시에 실행할 수 없다는 뜻이다.
-
그래서 JavaScript 코드는 위에서 아래로 한 줄씩 실행되고, 한 시점에 실행 중인 함수는 하나다.
-
이 성질은 짧은 코드로 확인할 수 있다.
const start = Date.now(); setTimeout(() => { console.log(`타이머 콜백 실행: ${Date.now() - start}ms`); }, 10); // 10ms 뒤에 실행해 달라고 맡긴다 while (Date.now() - start < 500) {} // 500ms 동안 스레드를 붙잡는 반복문 console.log(`반복문 끝: ${Date.now() - start}ms`); -
타이머에는 10ms 뒤에 실행해 달라고 했지만 출력은 다음과 같다.
반복문 끝: 500ms 타이머 콜백 실행: 509ms -
10ms가 지난 시점에 스레드는
while반복문을 실행하고 있었다. -
스레드가 하나뿐이어서, 반복문이 실행되는 동안에는 타이머에 맡긴 함수를 실행할 다른 흐름이 없다.
-
그래서 타이머에 맡긴 함수는 반복문이 끝나 스레드가 빈 뒤에야 실행되었다.
-
이 글에서 "JavaScript는 싱글 스레드다"라는 말은 이 성질, 즉 JavaScript 코드가 한 스레드에서 한 번에 하나씩 실행된다는 뜻으로 쓴다.
Node.js를 이루는 두 부품: V8과 libuv
- 스레드가 어디에 몇 개 있는지 말하려면 Node.js가 무엇으로 이루어져 있는지부터 알아야 한다.
- Node.js는 JavaScript 언어가 아니라, JavaScript 코드를 브라우저 밖에서 실행해 주는 프로그램이다.
- 터미널에
node app.js를 입력하면 운영체제는 Node.js 프로세스를 하나 만들고, 이 프로세스가app.js를 읽어 실행한다. - 이때 JavaScript 코드를 해석하고 실행하는 일은 V8이 맡는다.
- V8은 Chrome에 들어 있는 JavaScript 엔진이고, Node.js는 이 엔진을 가져다 쓴다.
- 그런데 JavaScript 언어만으로는 파일을 읽거나 네트워크로 데이터를 주고받을 수 없다.
- 언어 명세인 ECMAScript가 입출력을 정의하지 않고 실행 환경에 맡기기 때문이다.
- Node.js에서는
fs,http같은 내장 모듈이 입출력 기능을 제공한다. - 내장 모듈은 겉으로는 JavaScript 함수이지만, 안에서는 C++ 코드를 거쳐 운영체제의 기능을 호출한다.
- 이 과정에서 입출력과 기다리는 일을 실제로 담당하는 것이 libuv다.
- libuv는 Node.js를 위해 만들어진 C 라이브러리로, 운영체제마다 다른 입출력 방식을 한 가지 방식으로 감싸서 제공한다.
- libuv가 제공하는 것 가운데 이 글에서 중요한 것은 이벤트 루프와 thread pool이다.
- 이벤트 루프는 끝난 일이 있는지 확인하고, 있으면 그 일에 맡겨진 함수를 실행하는 동작을 계속 반복하는 코드다.
- thread pool은 미리 만들어 두고 일을 나누어 맡기는 스레드 묶음이다.
- 두 가지가 어떻게 동작하는지는 뒤에서 다루고, 여기서는 Node.js 안에 JavaScript를 실행하는 V8과 입출력을 맡는 libuv가 함께 들어 있다는 점만 짚어 둔다.
Node.js에서 "싱글 스레드"가 가리키는 범위
-
Node.js 프로세스가 시작될 때 처음부터 있는 스레드를 메인 스레드라고 부른다.
-
메인 스레드는 V8에게 JavaScript 실행 환경을 하나 만들게 하는데, V8은 이 실행 환경을 Isolate라고 부른다.
-
Isolate는 자기만의 메모리와 상태를 가진 V8 엔진 한 벌이라고 보면 된다.
-
V8에는 Isolate 하나를 한 시점에 한 스레드만 사용할 수 있다는 규칙이 있다.
-
이 규칙은 Node.js 소스에 포함된 V8의 헤더 파일
v8-isolate.h에 주석으로 적혀 있다. -
그래서 Isolate 하나 안의 JavaScript 코드는 여러 스레드에서 동시에 실행될 수 없다.
-
메인 스레드는 libuv의 이벤트 루프도 하나 만들어서 같은 스레드에서 돌린다.
-
libuv 문서에 따르면 이벤트 루프도 스레드 하나에 묶여서 동작하도록 만들어졌다.
-
결국 메인 스레드 하나가 JavaScript 실행(Isolate)과 이벤트 루프를 모두 맡는다.
-
Node.js에서 "싱글 스레드"가 가리키는 것은 이 스레드, 즉 JavaScript 코드를 실행하는 스레드가 하나라는 사실이다.
-
반대로 이 말이 Node.js 프로세스 안에 스레드가 하나뿐이라는 뜻은 아니다.
-
프로세스에는 스레드를 여러 개 둘 수 있으므로, Node.js도 JavaScript를 실행하지 않는 보조 스레드를 따로 둔다.
-
보조 스레드는 크게 두 종류다.
-
첫째는 V8이 쓰는 스레드로, 쓰지 않는 메모리를 정리하는 가비지 컬렉션처럼 JavaScript 실행 뒤편에서 처리할 수 있는 내부 작업을 맡는다.
-
둘째는 libuv의 thread pool로, 파일 읽기처럼 시간이 걸리는 작업을 메인 스레드 대신 수행한다.
-
Linux에서는 프로세스의 스레드 목록이
/proc/self/task디렉터리에 나타나므로 개수를 직접 셀 수 있다.const fs = require('node:fs'); const countThreads = () => fs.readdirSync('/proc/self/task').length; console.log('시작 직후:', countThreads()); fs.readFile(__filename, () => { console.log('비동기 파일 읽기 뒤:', countThreads()); }); -
실행 결과는 다음과 같다.
시작 직후: 7 비동기 파일 읽기 뒤: 11 -
시작 직후의 7개는 메인 스레드 1개, V8의 보조 스레드 4개, Node.js가 내부 용도로 만드는 스레드 2개다.
-
파일 읽기를 한 번 요청한 뒤 늘어난 4개는 libuv의 thread pool이다.
-
thread pool은 처음 쓰이는 시점에 만들어지고 기본 크기가 4이므로, 첫 파일 읽기와 함께 4개가 한꺼번에 생겼다.
-
이렇게 스레드가 11개 있어도, 작성한 JavaScript 코드는 메인 스레드 하나에서만 실행된다.
-
보조 스레드는 JavaScript 코드를 실행하지 않고, 맡은 일을 끝내면 결과를 메인 스레드에 넘긴다.
-
그러므로 앞에서 본 "자바스크립트 코드는 한 번에 하나씩 실행된다"는 성질은 Node.js에서도 그대로 유지된다.
서버가 풀어야 하는 문제: 처리 시간의 대부분은 기다림이다
-
JavaScript를 실행하는 스레드가 하나라는 점이 왜 문제가 되는지 보려면 서버가 하는 일을 살펴봐야 한다.
-
웹 서버는 여러 사용자의 요청을 받는데, 요청은 앞의 요청이 끝나기를 기다렸다가 오지 않고 서로 겹쳐서 도착한다.
-
그리고 요청 하나를 처리하는 과정에서는 대개 계산보다 기다림이 훨씬 길다.
-
사용자 정보를 돌려주는 요청을 예로 들면, 서버는 요청을 해석하고, 데이터베이스에 질의를 보내고, 응답을 기다리고, 받은 결과로 응답을 만들어 보낸다.
-
여기서 데이터베이스는 서버 코드와 별개로 실행되는 프로그램이고, 흔히 다른 컴퓨터에 있다.
-
서버 코드는 네트워크 연결을 통해 질의를 보내고, 같은 연결로 결과가 돌아오기를 기다린다.
-
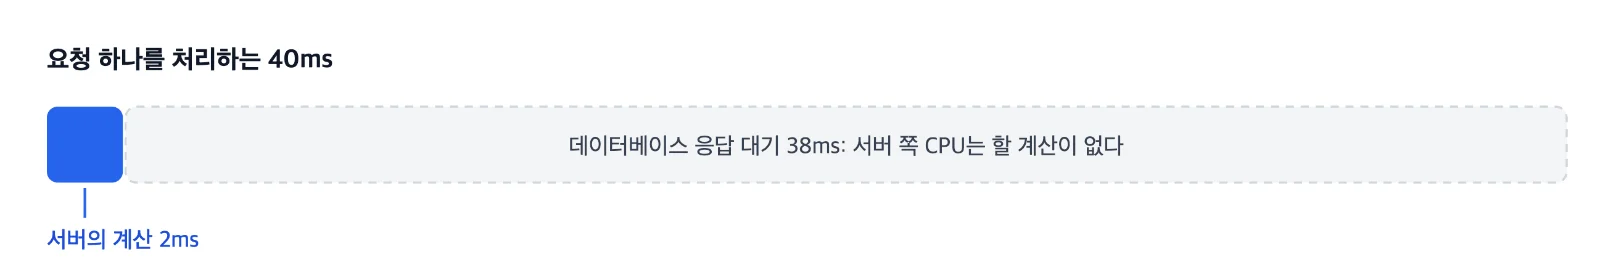
질의를 실제로 수행하는 것은 데이터베이스 쪽이므로, 그동안 서버 쪽 CPU가 이 요청을 위해 할 계산은 없다.
-
요청 하나에 40ms가 걸리고, 그중 2ms가 서버의 계산이며 38ms가 데이터베이스 응답을 기다리는 시간이라고 가정해보자.
-
가장 단순한 서버는 스레드 하나가 요청 하나를 처음부터 끝까지 붙잡고 처리한다.
-
이 서버에서 스레드는 질의를 보낸 뒤 응답이 올 때까지 그 자리에 멈춰 선다.
-
스레드가 이렇게 어떤 일이 끝나기를 기다리며 멈춰 있는 것을 blocking이라고 부른다.
-
스레드가 멈춰 있는 38ms 동안에는 다른 요청이 도착해도 그것을 처리할 흐름이 없다.
-
그래서 요청 100개가 한꺼번에 도착하면 100번째 요청은 앞의 99개가 끝날 때까지 기다려야 한다.
-
40ms씩 100번이므로 마지막 요청은 약 4초 뒤에야 응답을 받는다.
-
이 4초 가운데 서버가 실제로 계산한 시간은 2ms씩 100번인 200ms이고, 나머지 3.8초는 스레드가 멈춰서 기다린 시간이다.
-
따라서 서버가 풀어야 하는 문제는 기다리는 시간 동안 다른 요청을 처리할 방법을 마련하는 것이다.
해법 1: 요청마다 스레드를 하나씩 쓴다 (Node.js가 택하지 않은 방식)
-
이 절의 내용은 Node.js의 동작이 아니라, Node.js와 비교하기 위해 살펴보는 다른 서버들의 방식이다.
-
Node.js 가이드는 이런 방식을 쓰는 서버의 예로 Apache를 든다.
-
이 방법의 핵심은 실행 흐름을 늘리는 것이다.
-
요청이 올 때마다 스레드를 하나씩 배정하면, 한 스레드가 데이터베이스 응답을 기다리며 멈춰 있어도 다른 스레드가 다른 요청을 처리한다.
-
이 모델에서는 요청을 처리하는 코드를 위에서 아래로 그대로 쓸 수 있다.
// 요청마다 스레드를 쓰는 서버의 코드 모양이다 (Node.js 코드가 아니라 설명을 위한 의사 코드) function handleRequest(req, res) { const startedAt = Date.now(); const user = db.findUserSync(req.url); // 응답이 올 때까지 이 줄에서 스레드가 멈춘다 res.end(`${user.name}, ${Date.now() - startedAt}ms`); } -
스레드는
db.findUserSync를 호출한 줄에서 멈췄다가, 응답이 오면 멈췄던 자리의 다음 줄부터 이어서 실행한다. -
이것이 가능한 이유는 스레드마다 스택이 있기 때문이다.
-
멈춰 있는 동안에도 스택에는
handleRequest를 어디까지 실행했는지와startedAt같은 지역 변수가 남아 있다. -
Node.js 소개 문서는 이렇게 OS 스레드를 쓰는 방식을 오늘날 더 흔한 모델로 든다.
-
다만 이 방식에는 비용이 따른다.
-
스레드는 각자 스택을 위한 메모리를 차지하고, 운영체제가 스레드를 바꿔 가며 실행하는 데에도 시간이 든다.
-
응답을 기다리는 요청이 1만 개이면, 대부분 멈춰만 있는 스레드 1만 개를 유지해야 한다.
-
또 여러 스레드가 메모리를 함께 쓰기 때문에, 두 스레드가 같은 변수를 동시에 고치면 값이 어긋날 수 있다.
-
이를 막으려면 한 번에 한 스레드만 그 변수를 다루도록 잠그는 장치인 lock이 필요하다.
-
lock을 잘못 쓰면 스레드들이 서로가 잠근 것이 풀리기만 기다리며 계속 멈춰 있는 dead-lock이 생길 수 있다.
해법 2: 스레드는 하나로 두고, 기다리는 동안 다른 요청을 처리한다
-
Node.js는 스레드를 늘리는 대신, 스레드가 기다리느라 멈추는 일을 없애는 쪽을 택했다.
-
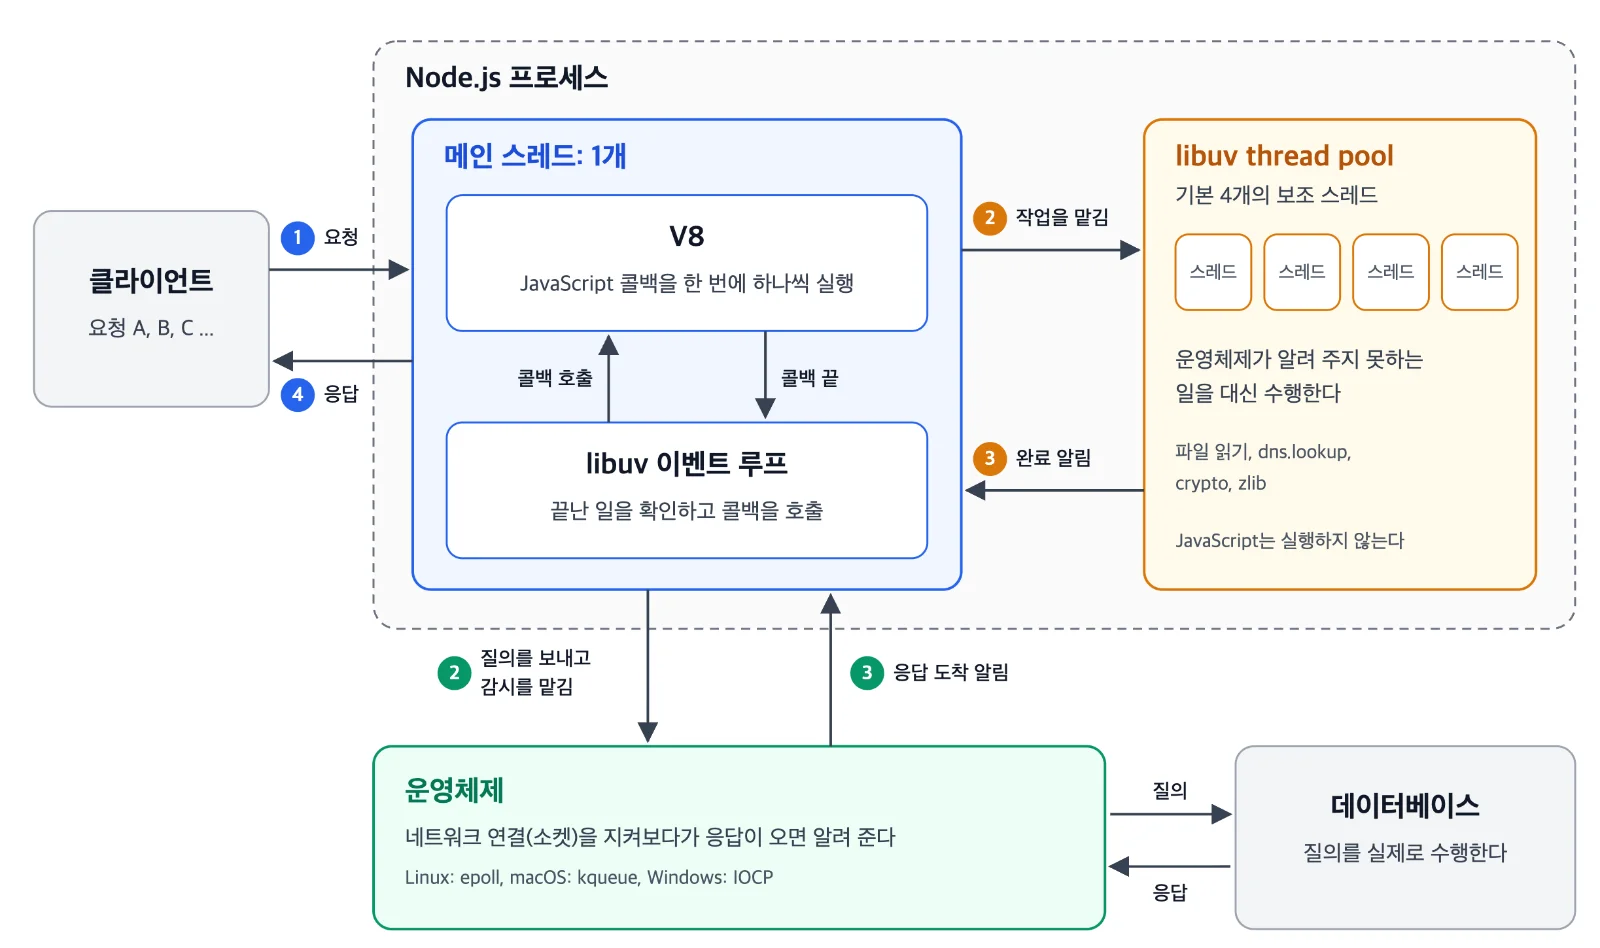
전체 구조를 먼저 그림으로 보면 다음과 같다.
-
JavaScript 코드는 메인 스레드 하나에서만 실행되고, 기다리는 일은 운영체제와 thread pool이 대신 맡는다.
-
그림의 번호는 요청 하나가 거치는 순서로, 요청이 도착하면(1) 콜백이 기다릴 일을 맡기고(2), 끝났다는 알림이 오면(3) 이벤트 루프가 콜백을 호출해 응답을 보낸다(4).
-
앞서 살펴본 예시에서, 38ms의 시간은 스레드가 해야 하는 일이 아니다.
-
그 시간에 일하는 것은 데이터베이스이고, 서버 쪽에서 필요한 것은 응답이 도착했다는 사실을 알아차리는 것이다.
-
응답이 도착했는지 지켜보는 일은 스레드가 매번 확인하지 않아도 된다.
-
네트워크로 들어오는 데이터는 운영체제가 받아서 보관하므로, 운영체제에게 도착하면 알려 달라고 부탁해 둘 수 있기 때문이다.
-
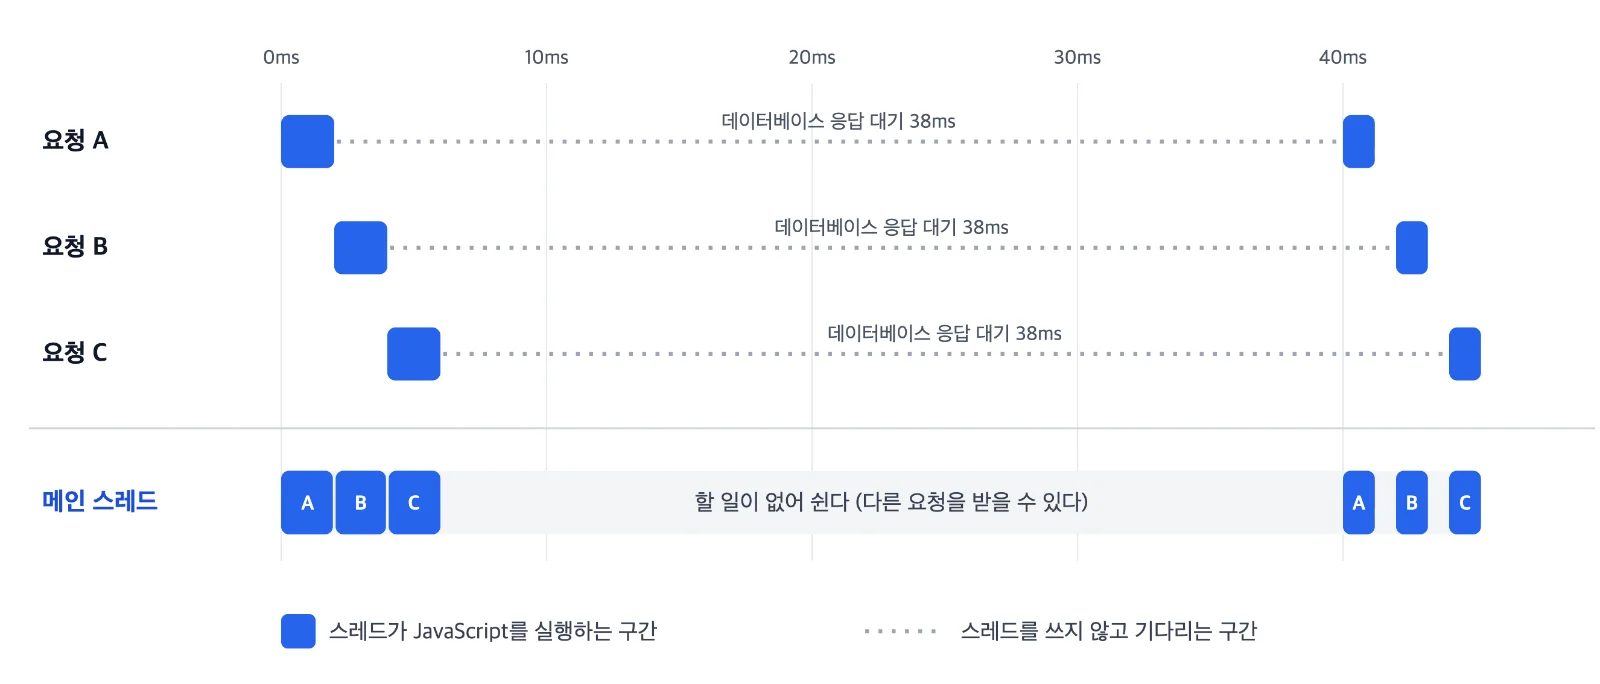
그러면 스레드는 요청 A의 계산을 2ms 동안 하고, 데이터베이스에 질의를 보낸 뒤, 응답을 기다리지 않고 곧바로 A에서 손을 뗀다.
-
손을 뗀 스레드는 그사이 도착해 있던 다음 작업인 요청 B의 계산을 시작한다.
-
나중에 A의 응답이 도착했다는 알림이 오면, 스레드는 하던 일을 마친 뒤 A의 나머지 처리를 이어서 한다.
-
위 그림에서 파란 칸은 스레드가 JavaScript를 실행하는 구간이고, 점선은 데이터베이스 응답을 기다리는 구간이며, 맨 아래 줄은 메인 스레드가 각 시점에 하는 일이다.
-
요청 세 개의 대기 구간은 서로 겹쳐서 흐르고, 스레드가 실제로 일하는 구간은 파란 칸뿐이다.
-
이렇게 하면 스레드가 요청 하나에 쓰는 시간은 40ms가 아니라 계산에 드는 2ms가 된다.
-
요청 100개가 한꺼번에 와도 스레드가 차례로 처리해야 하는 것은 2ms짜리 계산 100개, 약 200ms이다.
-
각 요청의 38ms 대기는 스레드 밖에서 서로 겹쳐 흐르므로 100번 더해지지 않는다.
-
그 결과 마지막 요청도 4초가 아니라 200ms에 대기 38ms를 더한 240ms 근처에서 응답을 받을 수 있다.
-
이렇게 다른 작업이 진행되는 동안 JavaScript 함수를 계속 실행해 나갈 수 있는 이벤트 루프의 수용력을 concurrency라고 부른다.
-
이 방식이 성립하려면 세 가지가 마련되어야 한다.
-
첫째, 질의를 보낸 뒤 응답이 오면 이어서 할 일을 어딘가에 맡겨 둘 방법이 있어야 한다.
-
둘째, 응답이 도착했다는 사실을 알아차리고 맡겨 둔 일을 실행해 줄 주체가 있어야 한다.
-
셋째, 운영체제에 끝나면 알려 달라고 부탁할 수 없는 종류의 작업을 대신 맡아 줄 곳이 있어야 한다.
-
첫째는 JavaScript의 콜백이, 둘째는 이벤트 루프가, 셋째는 thread pool이 맡으며, 아래에서 이 순서대로 살펴본다.
1-1. 나중에 할 일을 맡겨 두는 방법: 콜백
-
앞에서 꼽은 첫째 조건, 즉 응답이 오면 이어서 할 일을 맡겨 두는 수단이 콜백이다.
-
Node.js에서 시간이 걸리는 작업을 시작하는 함수는 대부분 작업을 시작만 시키고 바로 반환하며, 작업이 끝났을 때 실행할 콜백을 인자로 받는다.
-
파일을 읽는 두 함수를 비교하면 콜백이 하는 일이 드러난다.
-
아래 코드는 같은 파일을 동기 함수와 비동기 함수로 한 번씩 읽는다.
const fs = require('node:fs'); const text = fs.readFileSync(__filename, 'utf8'); // 다 읽을 때까지 이 줄에서 멈춘다 console.log('1. 동기 읽기 끝:', text.length); fs.readFile(__filename, 'utf8', (err, text) => { // 읽기를 맡기고 바로 다음 줄로 간다 console.log('3. 비동기 읽기 끝:', text.length); }); console.log('2. readFile 다음 줄'); -
출력은 다음과 같다.
1. 동기 읽기 끝: 305 2. readFile 다음 줄 3. 비동기 읽기 끝: 305 -
readFileSync는 파일을 다 읽을 때까지 그 줄에서 스레드를 멈추고, 읽은 내용을 반환값으로 돌려준다. -
readFile은 읽기를 시작시킨 뒤 바로 반환하므로2가 먼저 출력되고, 읽기가 끝난 뒤에 콜백이 실행되어3이 출력된다. -
즉 콜백은 기다린 뒤에 이어서 실행할 코드를 함수로 묶어 Node.js에 맡겨 두는 역할을 한다.
-
앞의 방식을 동기(synchronous) 또는 blocking이라 하고, 뒤의 방식을 비동기(asynchronous) 또는 non-blocking이라고 한다.
1-2. 콜백이 요청의 정보를 기억하는 방법: 클로저
-
콜백으로 나중에 할 일은 맡길 수 있게 되었지만, 문제가 하나 남는다.
-
응답을 보내려면 어느 사용자에게 보낼지, 요청이 언제 시작되었는지 같은 정보가 필요하다.
-
요청마다 스레드를 쓰는 모델에서는 멈춰 있는 스레드의 스택에 이 정보가 남아 있었다.
-
콜백 방식에서는 질의를 맡긴 함수가 기다리지 않고 바로 끝나므로, 정보를 보관할 다른 방법이 필요하다.
-
이 역할을 클로저가 맡아서, 콜백은 자신을 만든 함수의 변수를 붙잡고 있다가 나중에 실행될 때 그대로 사용한다.
-
두 모델의 코드를 나란히 놓으면 무엇이 무엇을 대신하는지 보인다.
// 스레드 모델 (Node.js 코드가 아니다): 스레드가 멈추고, 스택이 위치와 변수를 기억한다 function handleRequest(req, res) { const user = db.findUserSync(req.url); // 여기서 스레드가 멈춘다 res.end(user.name); // 깨어난 뒤 이어서 실행한다 } // 콜백 모델 (Node.js): 함수는 바로 끝나고, 콜백과 클로저가 그 역할을 대신한다 function handleRequest(req, res) { findUser(req.url, (user) => { // 이어서 할 일을 콜백에 담아 맡긴다 res.end(user.name); // 콜백이 바깥의 res를 기억하고 있다 }); } -
콜백 모델의
res는 콜백 바깥에서 만들어진 변수이지만, 콜백이 클로저로 붙잡고 있어서 응답이 온 뒤에도 쓸 수 있다. -
요청마다 함수가 새로 호출되고 변수도 새로 만들어지므로, 각 요청의 콜백은 자기 요청의 변수만 기억한다.
-
스레드 모델에서 멈춘 줄의 다음 줄이었던 코드가 콜백 모델에서는 콜백 함수의 본문이 된다.
-
스레드 모델에서 스택이 붙잡고 있던 지역 변수는 콜백 모델에서 클로저가 붙잡는다.
-
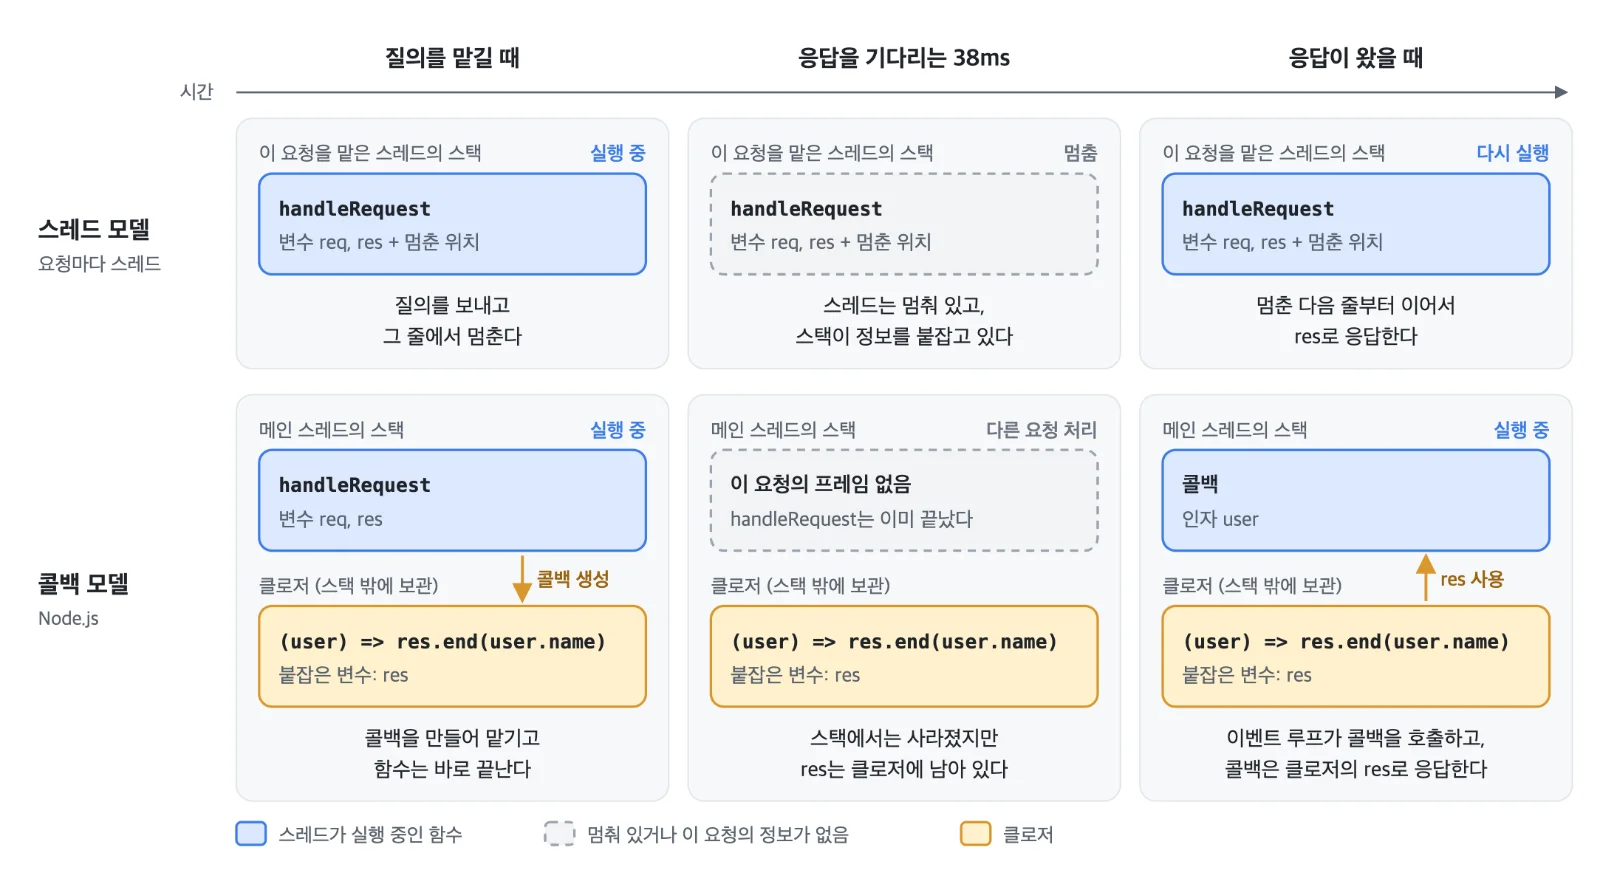
요청의 정보가 어디에 남아 있는지를 시간 순서로 그리면 다음과 같다.
-
위 줄이 스레드 모델, 아래 줄이 콜백 모델이며, 가운데 칸이 응답을 기다리는 동안의 모습이다.
-
정리하자면, 요청 하나를 처리하는 코드는 한 번에 끝까지 실행되지 않고, 두 번에 나뉘어 실행된다.
-
먼저
handleRequest가 질의를 보내고 끝나고, 응답이 온 뒤에 콜백이 사용자에게 결과를 돌려준다. -
그 사이 38ms 동안 스레드는 이 요청을 위해 할 일이 없으므로 다른 요청을 처리한다.
2-1. 맡겨 둔 콜백을 실행하는 주체: 이벤트 루프
-
맡겨 둔 콜백을 때가 되었을 때 꺼내 실행하는 것이 이벤트 루프다.
-
이벤트 루프는 libuv가 제공하며, 메인 스레드에서 도는 반복문이다.
-
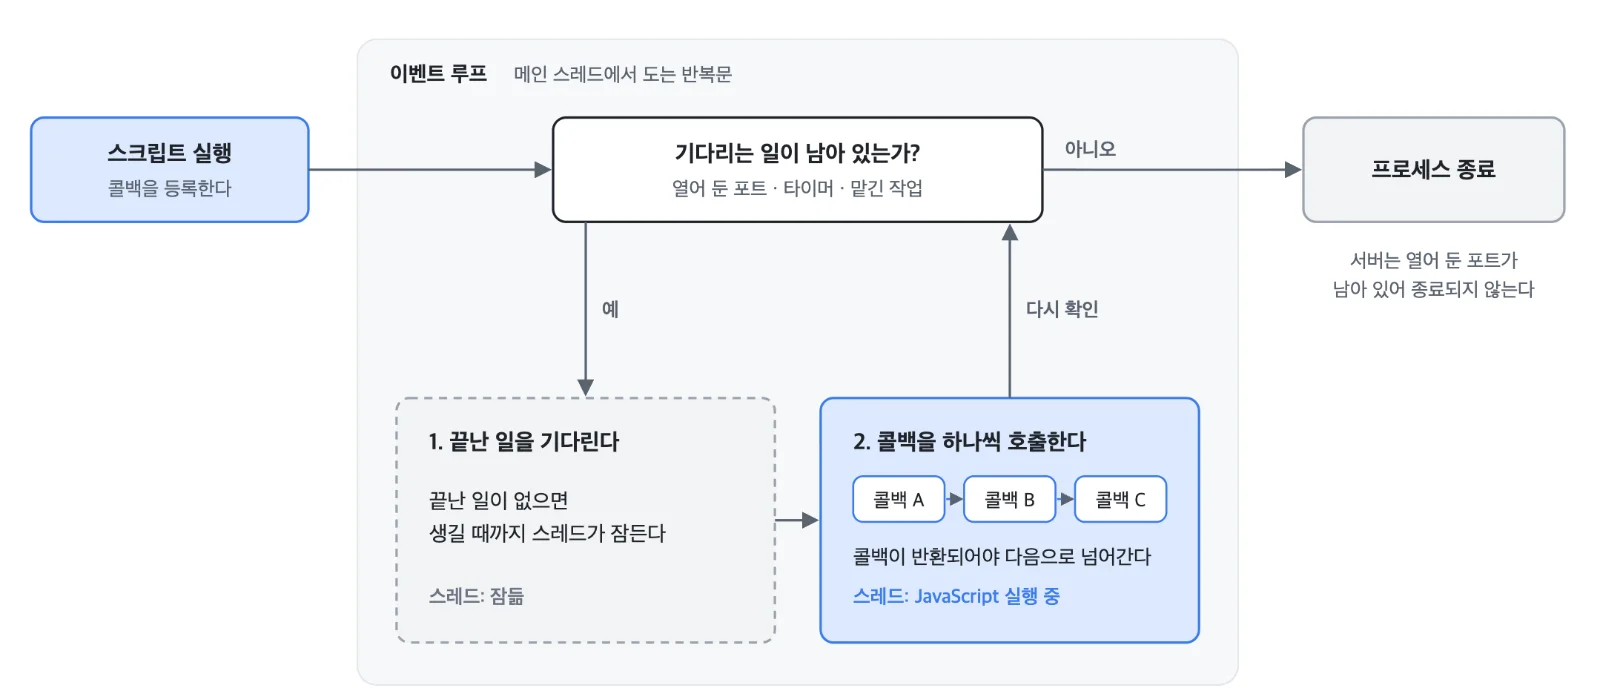
반복문이 한 바퀴 돌 때 하는 일을 그림으로 나타내면 다음과 같다.
-
실제 이벤트 루프는 타이머를 처리하는 단계, 입출력을 처리하는 단계처럼 여러 단계로 나뉘어 있지만, 뼈대는 이 그림과 같다.
-
한 바퀴는 두 단계인데, 먼저 맡겨 둔 일 가운데 끝난 것이 있는지 확인하고, 없으면 생길 때까지 스레드가 잠든다.
-
끝난 일이 있으면 그 일에 맡겨진 콜백을 하나씩 호출하고, 콜백이 반환되어야 다음 콜백으로 넘어간다.
-
JavaScript를 실행하는 스레드가 하나이고 이 반복문이 콜백을 하나씩 호출하므로, 콜백 하나가 시작되면 그 콜백이 끝날 때까지 다른 콜백은 시작되지 않는다.
-
그래서 콜백 안에서는 변수를 읽고 고치는 사이에 다른 콜백이 끼어들어 값을 바꾸는 상황을 걱정하지 않아도 된다.
-
Node.js는 시작하면 먼저 작성된 스크립트를 처음부터 끝까지 실행한다.
-
이때
http.createServer(...).listen(3000)같은 코드가 실행되면서 요청이 오면 실행할 콜백이 등록된다. -
스크립트 실행이 끝나면 Node.js는 이벤트 루프로 들어간다.
-
서버 프로그램이 스크립트의 마지막 줄을 실행한 뒤에도 종료되지 않는 이유가 여기에 있다.
-
열어 둔 서버 포트처럼 기다리는 일이 남아 있으므로 반복문이 계속 돈다.
-
반대로 기다리는 일이 하나도 없으면 반복문을 빠져나와 프로세스가 종료된다.
2-2. 네트워크 응답을 알아차리는 방법: 운영체제에 맡긴다
-
앞의 예에서 기다리는 대상은 데이터베이스의 응답이고, 이것은 네트워크로 들어오는 데이터다.
-
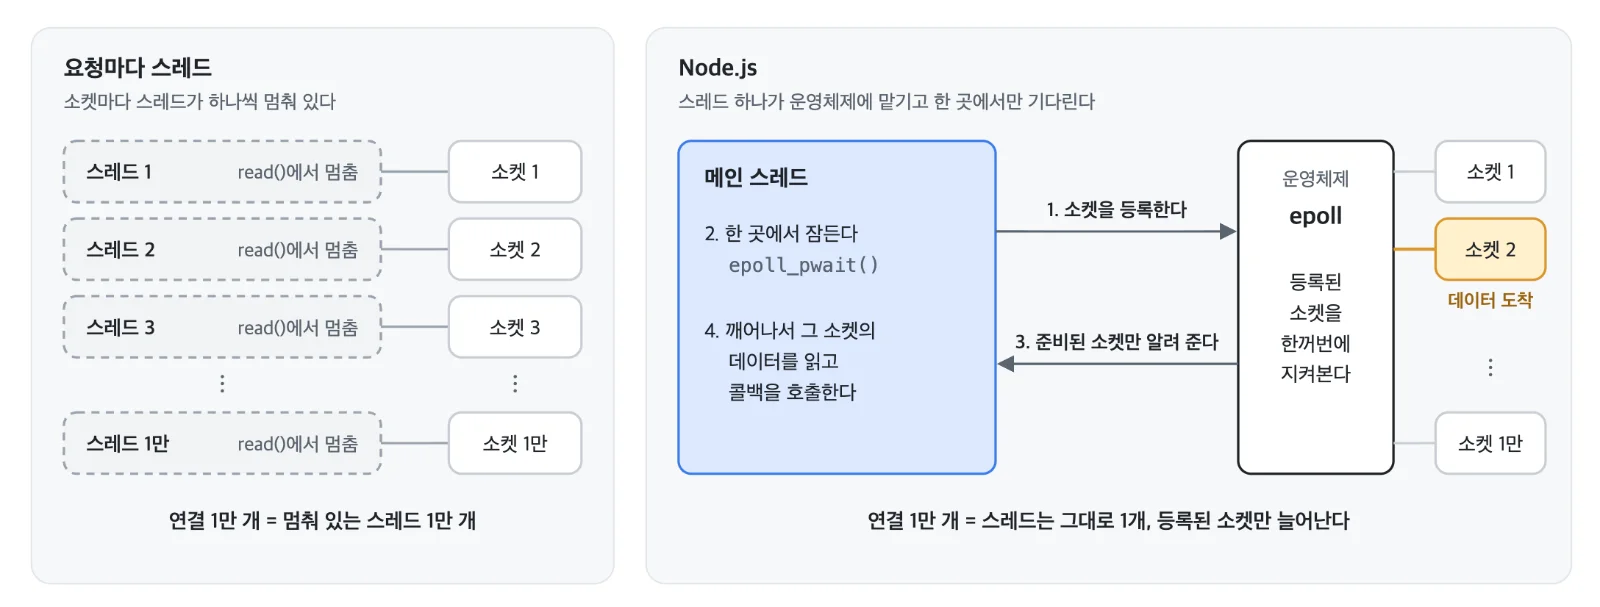
자세한 과정에 앞서 결론을 그림으로 보면 다음과 같다.
-
그림의 번호는 메인 스레드가 응답 하나를 알아차리기까지의 순서이며, 아래에서 차례로 살펴본다.
-
프로그램이 네트워크 연결 하나를 다룰 때 쓰는 통로를 소켓이라고 한다.
-
소켓은 운영체제가 만들어 관리하며, 프로그램에는 file descriptor라는 번호로 알려 준다.
-
프로그램은 이 번호를 들고 운영체제에게 5번 소켓에 도착한 데이터를 달라는 식으로 요청한다.
-
이 요청을 하는 함수가
read()인데, 소켓의 기본 동작에서는 도착한 데이터가 없으면read()를 호출한 스레드가 데이터가 올 때까지 멈춘다. -
요청마다 스레드를 쓰는 모델은 이 기본 동작을 그대로 사용한다.
-
libuv는 소켓을 non-blocking으로 설정해서 이 동작을 바꾼다.
-
libuv 소스에서 소켓을 만드는 코드는
socket()호출에SOCK_NONBLOCK옵션을 붙인다. -
non-blocking 소켓에서는 도착한 데이터가 없을 때
read()가 멈추지 않고, 아직 없다는 뜻의 오류EAGAIN을 바로 돌려준다. -
이제 스레드는 멈추지 않지만, 언제 다시 읽어 봐야 하는지를 알 방법이 필요해진다.
-
소켓 1만 개를 하나씩 돌아가며 계속
read()하는 것은 CPU를 낭비하게 된다. -
운영체제는 이 문제를 위해 여러 file descriptor를 한꺼번에 지켜보다가 준비된 것만 알려 주는 기능을 제공하며, Linux에서는 이 기능의 이름이 epoll이다.
-
사용법은 두 단계인데, 먼저 관심 있는 소켓들을 epoll에 등록해 둔다.
-
그런 다음
epoll_wait()를 호출하면, 등록된 소켓 가운데 하나라도 준비될 때까지 스레드가 잠들고, 깨어날 때 준비된 소켓의 목록을 받는다.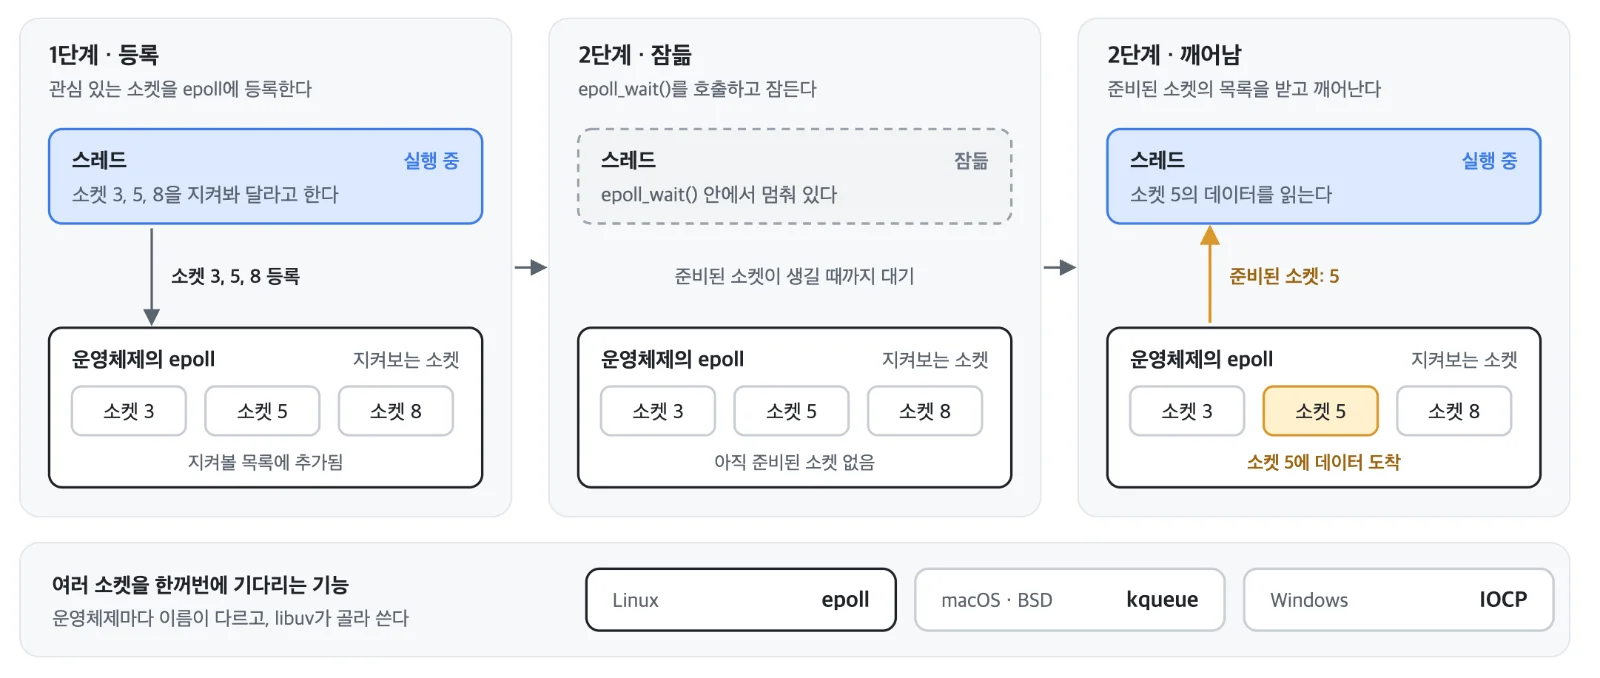
-
libuv 문서에 따르면 libuv는 Linux에서는 epoll을, macOS와 BSD에서는 kqueue를, Windows에서는 IOCP를 같은 용도로 사용한다.
-
앞 절 그림의 "끝난 일을 기다린다" 단계에 해당하는 것이 Linux에서는 이 호출이다.
-
libuv 소스에서 이벤트 루프는 한 바퀴마다
epoll_pwait()를 호출하고, 돌려받은 소켓마다 연결된 콜백을 실행한다. -
여기서 요청마다 스레드를 쓰는 모델과의 차이가 분명해진다.
-
그 모델에서는 스레드 1만 개가 각자 자기 소켓 하나 앞에서 멈춰 있었다.
-
Node.js에서는 스레드 하나가 소켓 1만 개의 감시를 운영체제에 맡겨 두고
epoll_pwait()한 곳에서만 기다린다. -
그래서 연결이 늘어나도 스레드는 늘지 않고, 늘어나는 것은 epoll에 등록된 소켓과 연결마다 보관하는 콜백이다.
-
처리할 일이 하나도 없을 때는 스레드가
epoll_pwait()안에서 잠들어 있으므로 CPU를 쓰지 않는다. -
데이터베이스 질의도 이 경로를 탄다.
-
질의를 보내는 것은 데이터베이스와 연결된 소켓에 데이터를 쓰는 일이고, 응답을 받는 것은 그 소켓에 데이터가 도착하는 일이다.
-
응답이 도착하면
epoll_pwait()가 그 소켓을 돌려주고, 이벤트 루프가 데이터를 읽어서 맡겨 두었던 콜백을 호출한다. -
기다림을 운영체제에 맡긴다는 말의 실제 내용이 이것이다.
3. 운영체제가 알려 주지 못하는 일: thread pool에 맡긴다
-
모든 작업을 이 방식으로 기다릴 수 있는 것은 아니다.
-
대표적인 예가 파일 읽기다.
-
libuv 문서는 네트워크와 달리 파일 입출력에는 운영체제마다 믿고 쓸 만한 수단이 없어서, 멈추는 방식의 파일 입출력을 thread pool에서 실행한다고 설명한다.
-
메인 스레드가 직접 멈추면 다른 요청을 처리할 수 없으므로, 멈춰도 되는 스레드를 따로 두고 그쪽에서 파일을 읽게 한다는 뜻이다.
-
이 스레드 묶음이 thread pool이고, 앞에서 스레드 수를 셀 때 늘어난 4개가 여기에 속한다.
-
fs.readFile이 처리되는 과정을 그림으로 보면 다음과 같다.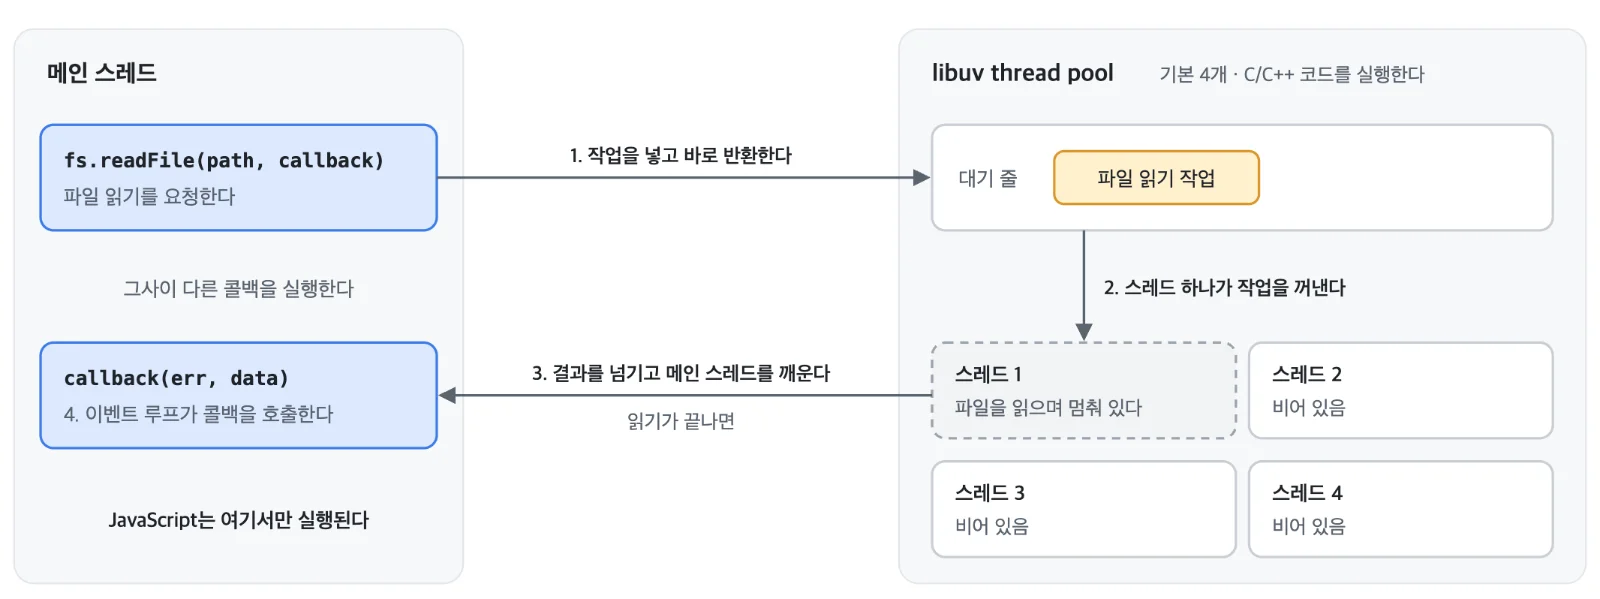
-
JavaScript 코드가
fs.readFile(path, callback)을 호출하면, 메인 스레드는 이 파일을 읽어 달라는 작업을 thread pool의 대기 줄에 넣고 곧바로 반환한다. -
thread pool의 스레드 하나가 대기 줄에서 그 작업을 꺼내 파일을 읽으며, 이때 멈추는 것은 이 스레드다.
-
읽기가 끝나면 그 스레드는 결과를 이벤트 루프 쪽에 넘기고, 잠들어 있을 수 있는 메인 스레드를 깨운다.
-
메인 스레드의 이벤트 루프는 이 완료를 확인하고
callback을 호출한다. -
libuv 문서도 thread pool에서 작업이 끝난 뒤의 콜백은 루프 스레드에서 호출된다고 밝힌다.
-
그래서 thread pool을 거치더라도 JavaScript 콜백은 여전히 메인 스레드에서만 실행된다.
-
thread pool의 스레드가 실행하는 것은 파일을 읽는 C/C++ 코드이고, 작성한 JavaScript 코드가 아니다.
-
기다릴 대상 없이 계산 자체가 오래 걸리는 작업 가운데 일부도 같은 방식으로 thread pool에 맡겨진다.
-
Node.js 문서가 thread pool을 사용한다고 밝힌 API는 파일 감시 API와 동기 API를 제외한
fsAPI,crypto.pbkdf2()같은 비동기 crypto API, 호스트 이름을 IP 주소로 바꾸는dns.lookup(), 동기 API를 제외한zlibAPI다. -
thread pool의 크기는 기본 4이고,
UV_THREADPOOL_SIZE환경 변수로 최대 1024까지 바꿀 수 있다. -
정리하면 Node.js에는 기다림을 맡기는 길이 두 갈래 있다.
-
네트워크는 운영체제에 맡겨
epoll_pwait()로 알림을 받고, 파일과 일부 무거운 계산은 thread pool에 맡겨 완료 통지를 받는다. -
두 길 모두 끝에서는 이벤트 루프가 메인 스레드에서 JavaScript 콜백을 호출한다는 점이 같다.
요청 두 개가 겹쳐 처리되는 과정 따라가기
-
지금까지의 내용을 요청 두 개가 처리되는 과정으로 이어 본다.
-
아래 코드에서
handleRequest는 요청 하나를 처리하는 함수이고,findUser는 응답까지 1초가 걸리는 데이터베이스를 흉내 낸다.// 데이터베이스를 흉내 내는 함수다. 1초 뒤에 결과를 콜백에 넘겨준다. function findUser(name, callback) { setTimeout(() => callback(`${name}의 정보`), 1000); } // 요청 하나를 처리하는 함수다. function handleRequest(name) { console.log(`${name}: 질의를 맡긴다`); findUser(name, (user) => { // 응답이 오면 실행될 콜백 console.log(`${name}: ${user}를 돌려준다`); }); } handleRequest('A'); handleRequest('B'); console.log('두 요청을 모두 받았다'); -
실행하면 다음과 같이 출력된다.
A: 질의를 맡긴다 B: 질의를 맡긴다 두 요청을 모두 받았다 A: A의 정보를 돌려준다 B: B의 정보를 돌려준다 -
먼저
handleRequest('A')가 실행되어 질의를 맡기고, 응답을 기다리지 않고 바로 끝난다. -
스레드가 비었으므로 곧바로
handleRequest('B')가 실행되고, 이것도 질의를 맡기고 끝난다. -
셋째 줄이 출력된 시점에 두 요청은 모두 응답을 기다리는 중이고, 스레드는 어느 요청에도 묶여 있지 않다.
-
실행할 코드가 더 없으므로 이벤트 루프는 끝난 일이 생길 때까지 기다린다.
-
1초 뒤 A의 응답이 준비되면 이벤트 루프가 A의 콜백을 호출하고, 콜백은 클로저로 기억하고 있던
name을 써서 결과를 돌려준다. -
이어서 B의 콜백이 같은 방식으로 실행된다.
-
두 요청이 각각 1초씩 기다렸지만, 전체 실행은 2초가 아니라 약 1초 만에 끝났다.
-
두 요청의 기다림이 스레드 밖에서 겹쳐 흘렀기 때문이다.
-
어느 시점에도 실행 중인 콜백은 많아야 하나였지만, 두 요청이 처리되는 구간은 서로 겹쳐 있었다.
-
이처럼 한 스레드가 여러 일의 짧은 조각을 번갈아 실행해서 여러 일이 함께 진행되게 하는 것이 앞에서 본 concurrency다.
-
여러 코어가 같은 순간에 각자 계산을 하는 것은 parallelism이라고 하며, concurrency와 구분된다.
await로 써도 구조는 같다
- 요즘의 Node.js 코드는 콜백을 직접 넘기는 대신
async함수와await를 자주 쓴다. await라는 이름 때문에 스레드가 그 줄에서 멈춰 기다리는 것처럼 보이지만, 동작은 콜백과 같다.async함수는await를 만나면 그 자리에서 실행을 멈추고, 자신을 호출한 쪽으로 제어를 돌려준다.- 멈추는 것은 그 함수 하나이고 스레드가 아니므로, 스레드는 다른 코드를 계속 실행한다.
await아래에 적힌 나머지 코드는 기다리던Promise가 완료되었을 때 실행되도록 예약된다.- 결국
await아랫부분이 콜백의 본문 역할을 하고, 함수의 지역 변수는 멈춘 함수와 함께 보존된다. - 그래서
await로 작성한 코드에도 뒤에서 볼 조건, 즉 한 번에 이어서 실행되는 구간이 짧아야 한다는 조건이 똑같이 적용된다.
약점 1: 콜백 하나가 오래 걸리면 모든 요청이 기다린다
-
지금까지 본 구조는 콜백이 금방 끝난다는 전제 위에 서 있다.
-
기다리는 일은 운영체제와 thread pool에 맡길 수 있지만, 콜백 안의 JavaScript 계산은 메인 스레드가 직접 해야 하기 때문이다.
-
그리고 메인 스레드는 하나이므로, 콜백 하나를 실행하는 동안에는 다른 콜백을 실행할 수 없다.
-
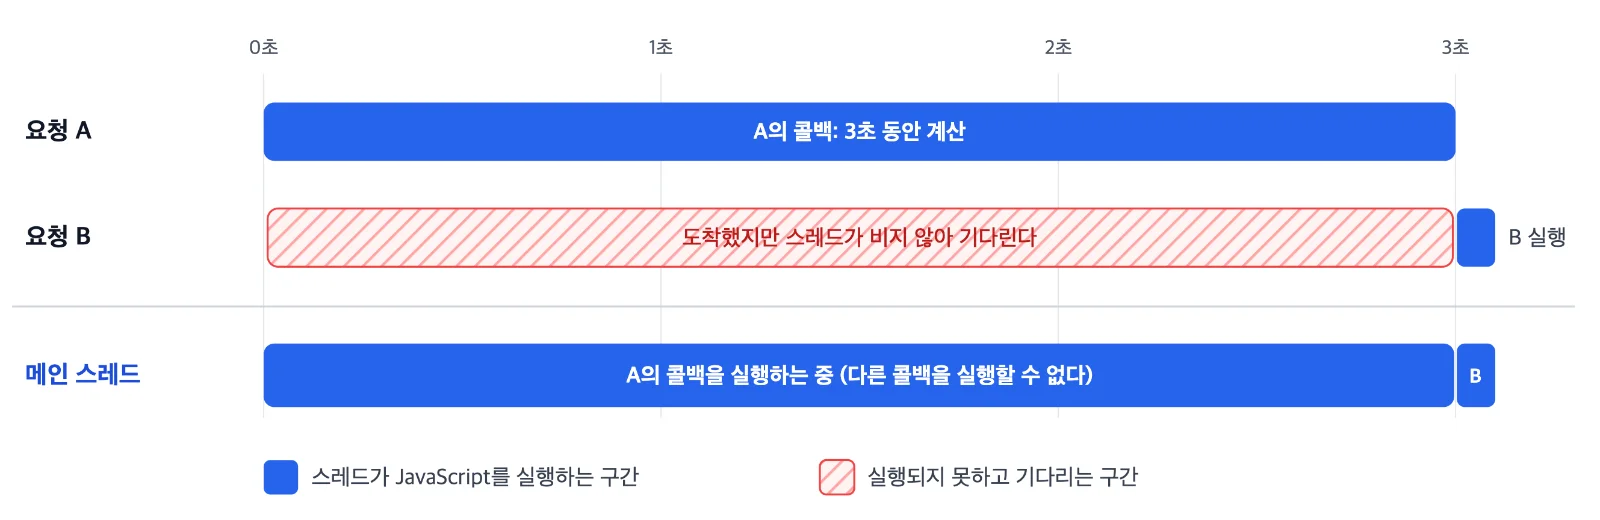
그래서 어떤 요청의 콜백이 3초 동안 계산을 하면, 그 3초 동안 다른 요청은 도착해도 처리가 시작되지 않는다.
-
타이머 두 개를 요청 두 개로 삼아 확인해 볼 수 있다.
// 요청 A의 콜백: 3초 동안 계산한다 setTimeout(() => { console.log('A 시작'); const end = Date.now() + 3000; while (Date.now() < end) {} // 3초 동안 스레드를 붙잡는다 console.log('A 끝'); }, 0); // 요청 B의 콜백: 0.01초 뒤에 실행해 달라고 맡겼고, 할 일은 한 줄이다 setTimeout(() => { console.log('B 실행'); }, 10); -
출력 순서는 다음과 같다.
A 시작 -> 바로 출력 A 끝 -> 약 3초 후 출력 B 실행 -> 약 3초 후 출력 -
B의 콜백은 0.01초 뒤에 실행되도록 맡겼지만, 실제로는
A 끝이 출력된 직후인 3초 뒤에 실행되었다. -
B가 할 일은 한 줄뿐인데도, A의 콜백이 스레드를 붙잡고 있는 동안에는 시작할 수 없었다.
-
서버에서 같은 일이 생기면, 오래 걸리는 요청 하나 때문에 그동안 들어온 다른 요청의 응답이 모두 늦어진다.
-
요청마다 스레드를 쓰는 서버에서는 한 스레드가 오래 계산해도 운영체제가 실행을 끊고 다른 스레드에 차례를 넘겨주지만, 이벤트 루프에는 실행 중인 콜백을 중간에 멈추는 장치가 없다.
-
오래 걸리는 계산만 이런 일을 일으키는 것은 아니어서,
fs.readFileSync()처럼 이름이Sync로 끝나는 동기 API도 작업이 끝날 때까지 메인 스레드를 멈춘다. -
그래서 Node.js 가이드는 요청 하나를 위해 한 번에 하는 일을 작게 유지하라고 권한다.
약점 2: thread pool이 가득 차면 작업이 줄을 선다
- 콜백을 짧게 쓰고 비동기 API만 사용해도 응답이 늦어지는 경우가 있다.
- 이번에는 메인 스레드가 아니라 thread pool 쪽에서 줄이 생긴다.
- thread pool의 스레드 수가 기본 4이고
fs,dns.lookup(), crypto,zlib이 이 풀을 함께 쓰므로, 오래 걸리는 암호화 작업 4개가 풀을 차지하고 있으면 그와 관련 없어 보이는 파일 읽기도 차례를 기다린다. - 이때 느려지는 것은 thread pool에 맡긴 작업이고, 메인 스레드는 멈추지 않으므로 네트워크 요청은 계속 받는다는 점이 약점 1과 다르다.
약점 3: JavaScript 실행은 코어 하나만 쓴다
- 마지막 약점은 계산 능력의 한계다.
- 스레드 하나는 한 시점에 CPU 코어 하나에서만 실행된다.
- JavaScript를 실행하는 스레드가 하나이므로, 서버에 코어가 8개 있어도 JavaScript 코드가 쓰는 것은 그중 하나다.
- 기다림이 대부분인 요청에서는 계산이 짧아서 이 한계가 잘 드러나지 않는다.
- 하지만 요청마다 JavaScript 계산이 오래 걸리는 서비스에서는 코어 하나의 처리 능력이 서버의 한계가 된다.
- 이 한계는 JavaScript를 실행하는 단위를 늘려서 넘는다.
- 방법은 두 가지로,
worker_threads모듈로 JavaScript 실행 스레드를 추가로 만들거나cluster모듈로 Node.js 프로세스를 여러 개 띄운다. - 어느 방법을 쓰든 실행 단위 하나의 안쪽은 지금까지 설명한 구조 그대로다.
정리
- Node.js에서 "싱글 스레드"는 JavaScript 코드와 콜백을 실행하는 스레드가 하나라는 뜻이다.
- 프로세스 안에는 V8의 보조 스레드와 libuv의 thread pool이 더 있지만, 이들은 작성한 JavaScript 코드를 실행하지 않는다.
- 스레드 하나로 많은 요청을 처리할 수 있는 이유는 요청 처리 시간의 대부분이 기다림이고, Node.js가 그 기다림에 스레드를 묶어 두지 않기 때문이다.
- 콜백은 기다림 뒤에 할 일을, 클로저는 요청의 정보를 스레드 없이 보관하게 해 준다.
- 이벤트 루프는 끝난 일을 확인하고 해당 콜백을 메인 스레드에서 하나씩 호출한다.
- 네트워크의 기다림은 운영체제가, 파일 입출력과 일부 무거운 계산은 thread pool이 맡는다.
- 이 구조가 잘 동작하려면 콜백이 짧아야 하며, 긴 계산과 동기 API는 그동안 다른 요청의 처리를 멈추게 한다.
- JavaScript 계산 자체가 많을 때는
worker_threads나cluster로 실행 단위를 늘린다.