AI 에이전트가 코드를 제대로 고치게 만드는 하네스 엔지니어링 경험
AI 에이전트로 리팩토링할 때 생기는 컨벤션 누락은 작업 절차를 담은 하네스와 컨텍스트를 분리한 검토 에이전트로 줄일 수 있었다. 폴더·상태 구조 설계부터 시행착오까지 정리한 경험기다.
개요
최근 커뮤니티에서 이런 글들이 보인다.
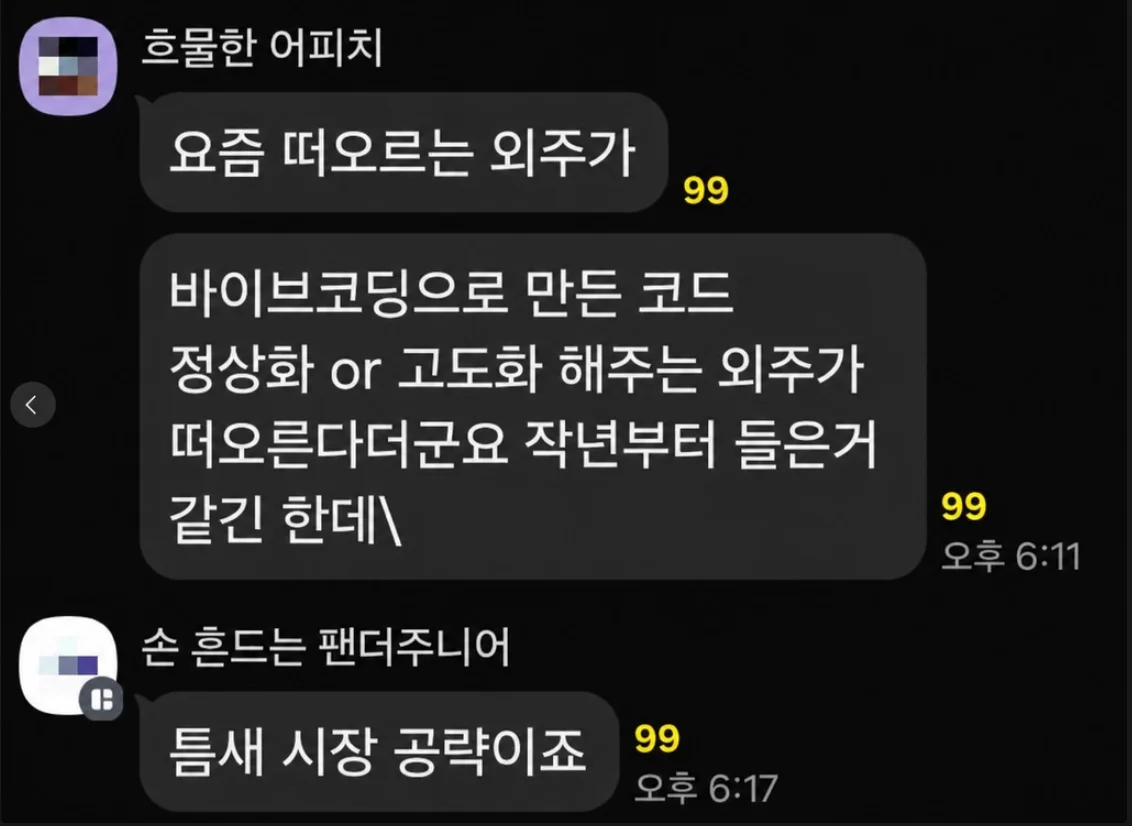
- 바이브 코딩으로 비개발자도 직접 서비스를 만들고 배포할 수 있는 시대가 되었다.
- AI로 MVP를 빠르게 구현하고, 시장에 내놓아 사용자의 반응을 확인하는 것은 합리적인 접근이라고 생각한다.
- 다만 그렇게 만든 서비스를 지속적으로 운영하고 확장하는 과정에서는 문제가 생긴다.
- 일관된 UI를 서비스에 맞게 다듬어야 하고, 기능이 늘어나면서 복잡해진 로직과 원인을 파악하기 어려운 오류도 해결해야 한다. 빠르게 만드는 것만큼, 이후에도 수정하고 확장할 수 있는 코드 기반을 갖추는 일이 중요해지는 것이다.
- 그래서 AI가 코드를 대신 작성하더라도, 코드의 구조를 이해하고 변경 방향을 판단하며 결과를 검증하는 개발자의 역할은 여전히 필요하다고 생각한다.
- 최근 AI로 빠르게 구축한 서비스의 코드를 리팩토링할 기회가 있었다. 이 글에서는 그 과정에서 어떤 기준을 세웠고, 반복적인 수정을 AI 에이전트에게 맡기면서 어떤 시행착오를 겪었는지 정리해보려고 한다.
배경
- 올해 3월 페이지랩스라는 스타트업에 프론트엔드 포지션으로 합류하고 처음 맡은 일은 기존 코드의 리팩토링이었다.
- 페이지랩스는 문항 제작부터 검토, 시험지 출력까지 교육 콘텐츠 제작에 필요한 업무를 지원하는 ERP 서비스를 운영하고 있다.
- 사내에서 사용하던 서비스를 SaaS 형식으로 확장하려는 시점이었고, 그 전에 앞으로 기능을 추가하고 수정할 수 있는 코드 기반을 만들어야 했다.
- 서비스의 규모는 이미 작지 않았다. 핵심 업무 기능이 여덟 개가 넘었고, 페이지도 수십 개에 달했다.
- AI를 적극적으로 활용해 빠르게 만든 서비스라서 그런지 코드를 읽어보니 파일마다 구현 방식이 달랐다.
- 하나의 파일에서 데이터를 가져오고, 입력값을 관리하고, 비즈니스 로직을 처리하고, 화면까지 그리는 경우가 많았다. 비슷한 버튼이나 모달도 페이지마다 따로 구현되어 있었다.
- 이러다보니 규칙 따위 없는 3000천 줄이 넘어가는 파일이 대다수여서 도저히 로직을 파악하기 힘들었다.
- 처음에는 어디서부터 손을 대야 할지 막막했다.
코드를 분석하며 반복되는 패턴 분석하기
- 파일 하나를 이해하려고 해도 그 안에서 다루는 일이 너무 많았다.
- 화면의 작은 부분을 수정하려다가 데이터 요청과 상태 변경 흐름까지 따라가야 했다.
- 그런데 코드를 계속 읽다 보니 반복되는 문제가 보였다.
- 화면과 API 호출이 한 파일에 섞여 있었고, 서버에서 가져온 데이터와 폼 입력값, 모달의 열림 여부가 모두 비슷한 방식으로 관리되고 있었다.
- 공통으로 쓸 수 있는 UI도 각 화면 안에 흩어져 있었다.
- 문제가 반복된다면 수정 또한 반복해서 처리할 수 있다고 생각했다.
- 모든 코드를 직접 고치는 것보다, 먼저 문제를 분류하고 기준을 정한 다음 반복적인 수정은 AI 에이전트에게 맡겨보기로 했다.
폴더 구조 정하기
- AI에게 수정을 맡기려면 먼저 내가 원하는 구조부터 정해야 했다. 즉, 컨벤션을 정해야 했다.
- 폴더 구조부터 정헀다. 우선 코드를 기능 단위로 나누고, 프로젝트 전반에서 공유할 부분을 분리하기로 했다.
- 처음부터 세부 계층을 많이 두기보다는
Features와Shared로 시작했다. - 한 번에 완전한 FSD(Feature Sliced Design) 아키텍처를 채택하지 않은 이유는, 분류가 세밀해질수록 어떤 파일을 어디에 둘지 애매해질 수 있다고 생각했기 때문이다.
- FSD는 어렵고 예외가 많이 필요해 매번 나의 의사결정이 필요한 구조라면 에이전트에게 반복 적용을 맡기기도 어려울 것 같았다.
상태 구조 정하기
- 상태 관리 기준을 정할 때 많은 시간을 썼다.
- 각 파일에
useState가 너무 많아서 의아했다. 실제로 어떤 값을 관리하고 있는지 확인하니, 상태의 개수보다 서로 다른 성격의 값을 한곳에서 다루는 것이 문제였다. - 서버에 원본이 있는 데이터도 컴포넌트가 로컬 상태로 들고 있었고, 폼 입력값과 로딩 여부, 화면의 일시적인 상태도 같은 위치에 선언되어 있었다.
- 같은 데이터를 여러 화면에서 사용해도 각자 따로 관리하니, 한 화면에서 수정한 내용이 다른 화면에 반영되도록 만드는 코드까지 필요했다.
- 그래서 상태의 소유권과 수명을 기준으로 분류하여 적용할 라이브러리를 선택했다.
- 서버에 원본이 있는 데이터는 서버 상태로, 제출할 때까지 관리하는 입력값은 폼 상태로, 모달의 열림 여부처럼 컴포넌트와 함께 생기고 사라지는 값은 지역 상태로 두었다.
- 에이전트에게 이런식으로 명확한 기준을 정해줘야 “
상태를 적절히 정리해줘”라고 단순히 말하는 것보다 더 확실히 작업할 수 있다고 생각했다. - 서버 상태에는
TanStack Query를 사용하고, 쿼리 키는 팩토리 패턴을 따르도록 했다. - ERP 서비스는 데이터 등록·수정·삭제가 빈번하기 때문에, 변경 사항을 관련 화면에 빠르게 반영하는 것이 중요하다.
- 쿼리 키를 사용하면 변경된 데이터와 관련된 캐시를 명확하게 식별하고,
invalidateQueries로 해당 쿼리를 무효화해 화면에서 사용 중인 데이터를 다시 조회할 수 있다. - 특히 쿼리 키를 도메인별로 계층화하면 목록과 상세 등 갱신 범위를 유연하게 지정할 수 있어, 불필요한 요청을 줄이면서 관련 화면의 데이터 일관성을 유지할 수 있다.
- 또한 팩토리 패턴으로 키 생성 로직을 한곳에 모아 중복과 오타를 줄이고, 조회와 무효화에 동일한 규칙을 적용해 유지보수성을 높였다.
- 폼 상태 관리는
React Hook Form으로 통일했다. - ERP 서비스는 입력 폼이 많고 구조도 복잡한데, 화면마다 입력값과 에러를 관리하는 방식이 달라 유지보수 비용이 크다고 생각했다.
- 이를 해결하기 위해 입력 필드 등록, 유효성 검증, 에러 표시, 제출 처리에 공통된 흐름을 적용하고, 화면마다 반복되던 상태 관리 코드를 줄이고자 해당 라이브러리를 선택했다.
- 또한 필요한 상태만 구독하도록 구성할 수 있어, 복잡한 폼에서 불필요한 재렌더링을 줄이는 데도 유리하다고 판단했다.
- 직접 만든 전용 훅을 사용할 수도 있었지만, 별도의 사용법을 계속 설명해야 하는 부담을 고려해 널리 쓰이는 API를 선택했다.
- 에이전트가 잘 아는 기술을 사용하는 것이 효율적이라고 생각했다.
컨벤션 기준 문서화
- 이외에도 타입 매칭, API, 컴포넌트 등 다양한 컨벤션을 정의하고 문서화했다.
- 내가 페이지마다 수정 방향을 설명하지 않아도 에이전트가 문서를 참고해 반복 작업을 수행할 수 있기를 기대했다.
- 이때까지는 이런식으로 기준을 정하는 일이 가장 중요하고, 이제 에이전트에게 시키면 리팩토링이 끝날 줄 알았다.
시행착오 1) 컨벤션 누락 발생 → 장기 실행 에이전트를 위한 효과적인 하네스
https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents
- 작업 단위는 하나의 페이지로 잡았다. 서비스 전체를 한 번에 바꾸기에는 범위가 너무 넓었고, 페이지를 기준으로 하면 어떤 기능을 수정했는지 직접 확인하기도 수월하다고 생각했다.
- 첫 시도에서는 단순히 “
컨벤션 문서들을 읽고 대상 페이지의 모든 파일에 적용하라”고 요청했다. - 결과는 기대와 달랐다. 에이전트는 작업을 마쳤다고 보고했지만, 직접 코드를 열어보니 일부 컨벤션이 적용되지 않았다.
- 처음에는 프롬프트의 표현이 충분히 명확하지 않았다고 생각해서 “빠짐없이”, “반드시 전부” 같은 키워드를 붙여 다시 요청해봤다. 하지만 비슷한 누락이 계속됐다.
- 같은 누락이 반복되면서, 에이전트가 해야 할 일을 빠뜨리지 않게 하려면 어떻게 요청해야 할지 고민했다.
- 그때 나는 “
내 요구사항을 전부 적용하라”는 말은 작업의 목표를 전달할 뿐, 여러 파일과 컨벤션을 어떤 순서로 확인하며 진행할지는 에이전트에게 맡겨두고 있었다. - 그래서 작업을 시작하기 전에 확인할 항목을 나열하고, 하나씩 처리하면서 남은 항목을 확인하도록 에이전트에게 생각하도록 시키면 누락을 줄일 수 있겠다고 생각했다.
- 이를 위해 작업 시작 위치인
page.tsx에서 import를 따라 대상 파일 목록을 만들고, 파일별로 확인할 컨벤션을 매트릭스로 정리하라는 지침을 추가했다. - 에이전트가 이 표를 기준으로 각 항목을 처리하고 체크하면서, 아직 처리하지 않은 항목으로 작업을 이어가도록 했다.
- 매트릭스를 적용한 뒤, 에이전트가 작업하는 과정과 실제 코드에서도 누락이 줄었는지 직접 확인했다.
- 에이전트는 작업 시작 전, 범위를 우선 파악한 뒤에 컨벤션 정합 매트릭스를 작성했다. 그리고 작업 시간 동안 체크 리스트를 스스로 처리하며 컨벤션을 적용해갔다.
- 결과를 확인해보니 이전보다 누락이 확연히 줄어들었다.
- 하지만 여전히 완료로 체크된 항목 중에도 컨벤션이 적용되지 않은 부분이 남아 있었다.
- 예를 들어 파일을
Features구조에 맞춰 옮겼지만 내부 코드에는 컨벤션을 적용하지 않았는데, 해당 항목은 ‘정합’으로 표시되어 있었다. - 매트릭스로 작업할 항목을 정해주는 것만으로는 충분하지 않았다.
- 에이전트가 항목을 체크했더라도, 실제 코드를 기준에 맞게 수정했는지는 다시 검증하는 단계가 필요했다.
- 그리고 그 검증은 “별도의 컨텍스트”가 필요하다고 생각했다.
시행착오2) 자체 검토에서도 남은 누락 → 검토 에이전트의 컨텍스트 분리
https://www.anthropic.com/engineering/building-effective-agents#workflow-evaluator-optimizer
- 어떻게 하면 에이전트가 일을 다 끝냈다는 착각에 빠지지 않도록 설계할지 고민했다.
- 메인 에이전트의 컨텍스트에는 코드를 수정한 과정과 함께 “이 파일은 적용 완료”라는 판단이 쌓여 있었다.
- 같은 대화에서 재검토를 요청하면, 앞서 작성한 완료 기록을 전제로 코드를 확인할 수도 있겠다고 생각했다.
- 그래서 이전 작업 과정과 완료 판단을 전달받지 않은 별도의 컨텍스트가 필요하다고 판단했다.
- 이를 위해
convention-auditor라는 검토용 에이전트를 만들었다. - 메인 에이전트는 컨벤션을 적용하고, 검토 에이전트는 실제 코드에서 컨벤션 위반을 찾도록 역할을 나눴다.
- 적용할 컨벤션이 이미 문서로 정리되어 있었기 때문에, 검토자에게도 동일한 기준을 전달할 수 있었다.
- 여기서 가장 신경 쓴 부분은 검토 에이전트에게
어떤 정보를 넘길지였다. - 검토에 필요한 맥락이 부족하면 파일의 역할이나 작업 범위를 잘못 이해할 수 있었다.
- 반대로 메인 에이전트의 판단을 전부 전달하면 컨텍스트를 분리한 목적이 흐려질 것 같았다.
- 그래서 작업 범위, 해당 라우트에서 사용하는 파일 목록과 각 파일의 역할, 적용 대상 컨벤션을 전달했다.
- 어떤 코드를 무슨 기준으로 확인해야 하는지는 알려주되, 메인 에이전트가 작성한 매트릭스는 전달하지 않았다.
- 매트릭스에는 이미 ‘완료’, ‘정합’이라는 판단이 들어 있었다. 이 표를 먼저 보여주면 검토 에이전트도 그 판단에 영향을 받을 수 있다고 생각했다.
- 검토자가 코드와 컨벤션을 직접 대조해 위반 목록을 만들게 하고, 그 결과를 받은 뒤 메인 에이전트의 작업 내역과 비교하도록 했다.
- 검토 에이전트가 위반 목록을 반환하면 메인 에이전트가 해당 내용을 확인하고 부족한 부분을 수정했다.
- 수정 결과는 다시 검토하도록 연결했다. 한 번의 완료 보고로 작업을 끝내던 흐름에, 별도 검토에서 나온 피드백을 반영하는 과정을 추가한 것이다.
- 다만 이 과정을 계속 반복하도록 두지는 않았다. 검토와 수정은 최대 3라운드로 제한하고, 그 이후에도 해결되지 않는 항목은 사용자에게 보고하도록 했다.
- 반복해도 해결되지 않는 경우에는 수정 횟수보다 판단 기준을 확인할 필요가 있다고 생각했다.
- 컨벤션이 모호해 두 에이전트의 해석이 갈릴 수도 있고, 해당 코드에 예외가 필요하거나 검토 에이전트가 정상적인 코드를 위반으로 판단했을 수도 있었다.
- 이런 상황에서 계속 자동으로 수정하게 하면 같은 부분을 되돌려 고치거나 불필요한 변경을 만들 수 있었다.
- 예를 들면,
Features와Shared의 경계에서 그런 문제가 생길 수 있다. 여러 화면에서 재사용하는 컴포넌트이면서 특정 도메인의 타입과 로직에 의존하는 경우, 재사용 여부를 우선하면Shared에 두게 되고, 도메인 의존성을 우선하면Features에 두게 된다. 컨벤션에 두 기준의 우선순위가 없다면, 에이전트가 파일을 옮겨도 다른 기준에서는 계속 위반으로 볼 수 있었다. 이런 상황은 수정 횟수를 늘리기 전에 사람이 기준을 정해야 한다고 생각했다.
- 예를 들면,
결과 및 정리
- 이번 경험에서는 리팩토링 기준을 문서화하고, 이를 AI 에이전트가 반복해서 적용하고 검토하는 절차까지 구축했다.
- 작업 범위 파악, 파일별 컨벤션 매트릭스 작성, 코드 수정, 별도 에이전트의 검토, 피드백 반영을 하나의 흐름으로 연결했다.
- 직접 검수한 범위에서는 컨벤션 누락이 눈에 띄게 줄었다. 초기에는 에이전트의 완료 보고를 받은 뒤에도 내가 누락된 항목을 찾아 다시 요청해야 했다.
- 체크리스트와 별도 검토. 단계를 도입한 이후에는 검토 에이전트가 발견한 위반을 메인 에이전트가 수정하도록 했고, 최종 검수에서는 대부분의 컨벤션이 적용된 것을 확인했다.
- 이 과정을 “스킬”로 묶어 여러 페이지에 반복 적용했다. 페이지가 바뀔 때마다 작업 순서와 검토 방식을 다시 설명할 필요 없이, 동일한 절차로 리팩토링을 진행할 수 있었다. 개별 페이지의 코드 개선과 함께, 이후 작업에도 재사용할 수 있는 리팩토링 절차를 남겼다.
- 이 경험을 통해 AI 에이전트의 작업 단위와 전달 정보를 정하고, 결과를 검토해 다시 수정하는 흐름을 설계하는 역량을 쌓을 수 있었다.
- 특히 누락이 발생했을 때 요청 문구를 수정하는 데서 그치지 않고, 작업 추적과 검토 구조를 바꾸어 관찰된 문제를 개선했다.
아쉬웠던 점
- 최종 결과는 만족스러웠지만, 컨벤션이 적용됐는지 매번 직접 코드를 확인해야 했다는 점은 아쉬웠다.
- 에이전트가 반복적인 수정을 수행하더라도, 내가 모든 파일을 다시 읽어야 한다면 페이지가 늘어날수록 검토에 드는 시간도 함께 늘어난다.
- 직접 검토하면서 누락이 줄었다는 것은 확인했지만, 어떤 컨벤션이 얼마나 자주 빠졌는지 수치로 남기지는 못했다.
- 그래서 작업 방식을 바꾼 효과를 정량적으로 비교하거나, 이후 스킬을 수정했을 때 이전보다 나아졌는지 같은 기준으로 평가하기는 어려웠다.
- 다음에는 컨벤션 중 기계적으로 판정할 수 있는 항목부터 자동으로 확인하고 싶다. 예를 들어 허용하지 않은 경로의 import가 있는지, 쿼리 키를 정해진 팩토리를 통해 생성하는지처럼 코드에서 확인할 수 있는 규칙은 린트나 정적 분석으로 검사하는 방식이다.
- 그렇게 해야 검토 단계를 추가한 만큼 효과가 있었는지, 어떤 규칙에서 여전히 누락이 발생하는지 더 구체적으로 알 수 있다.
- 이번에는 이런 평가 체계까지 만들지는 못했다. 우선 직접 검수하며 결과를 확인했지만, 앞으로 같은 방식을 더 넓게 사용하려면 반복적인 확인 작업도 자동화할 필요가 있다고 느꼈다.